Use este modelo
Uma excelente base de conhecimento poupa horas de tempo de suporte e acelera a forma como os utilizadores encontram respostas. Com a Trupeer, pode poupar horas no design da base de conhecimento começando com um modelo de base de conhecimento gratuito, personalizando-o com as suas orientações de marca e usando as nossas ferramentas base de conhecimento para lançar um hub totalmente pesquisável.
O que é um modelo de base de conhecimento e o que é que contém, na prática?
Um modelo de base de conhecimento é a estrutura do contentor: as categorias, as regras sobre o que pode ser adicionado, quem é o responsável por cada área e como é que algo é removido. Não é a estrutura das páginas que estão dentro dele.
Esta distinção é importante porque, normalmente, os dois são vendidos em conjunto e resolvem problemas diferentes. A estrutura das páginas torna uma resposta individual clara. A estrutura do contentor torna qualquer resposta encontrável entre outras quatro mil. Pode ter artigos excelentes numa base de conhecimento inutilizável, e esta é a falha mais comum das duas.
Se o que precisa é a estrutura das próprias páginas, ou seja, títulos, âmbito, passos e os campos que cada tipo exige, isso está coberto nos nossos modelos de artigos da base de conhecimento. Esta página cobre tudo o que está à volta deles.
Porque é que as bases de conhecimento falham por acumulação, e não por negligência
A história que a maioria das equipas espera é que a base de conhecimento fique desatualizada porque ninguém a atualiza. Isso acontece, mas não é o que normalmente a destrói.
O que costuma acontecer é que funciona bem durante cerca de dezoito meses e depois, silenciosamente, deixa de funcionar. Nada foi apagado, nada avariou e ninguém tomou uma decisão. A biblioteca simplesmente cresceu e, um dia, ao pesquisar uma política, aparecem trinta resultados, dos quais a maioria são notas de reuniões que a mencionam de passagem. As pessoas tentam duas vezes, não encontram nada útil e voltam a pedir a um colega. A partir daí, a base de conhecimento está tecnicamente completa e funcionalmente morta.
O mecanismo é a diluição da pesquisa. Uma base de conhecimento é tão boa quanto o seu pior resultado de pesquisa, porque um leitor que não consegue perceber qual dos nove resultados é o mais autoritativo, na prática, não encontrou nada. Adicionar conteúdo bom não resolve isto. Recusar conteúdo mau resolve.
Como personalizar este modelo na Trupeer
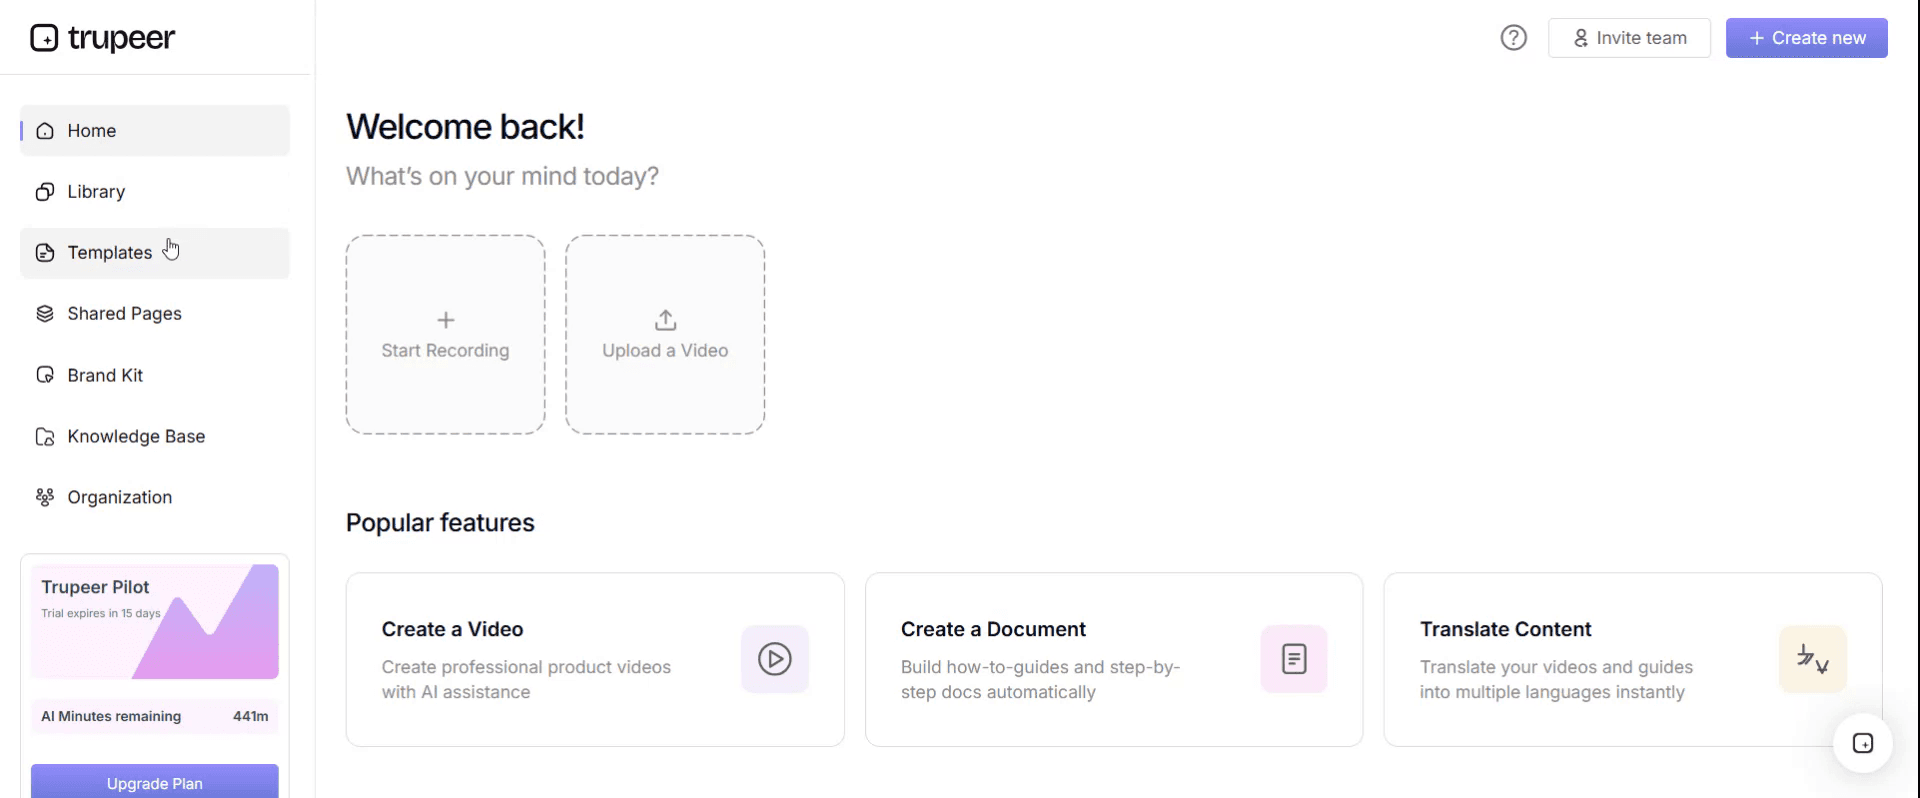
Passo 1: Abrir a secção de Modelos
Vá à secção de Modelos no menu principal.
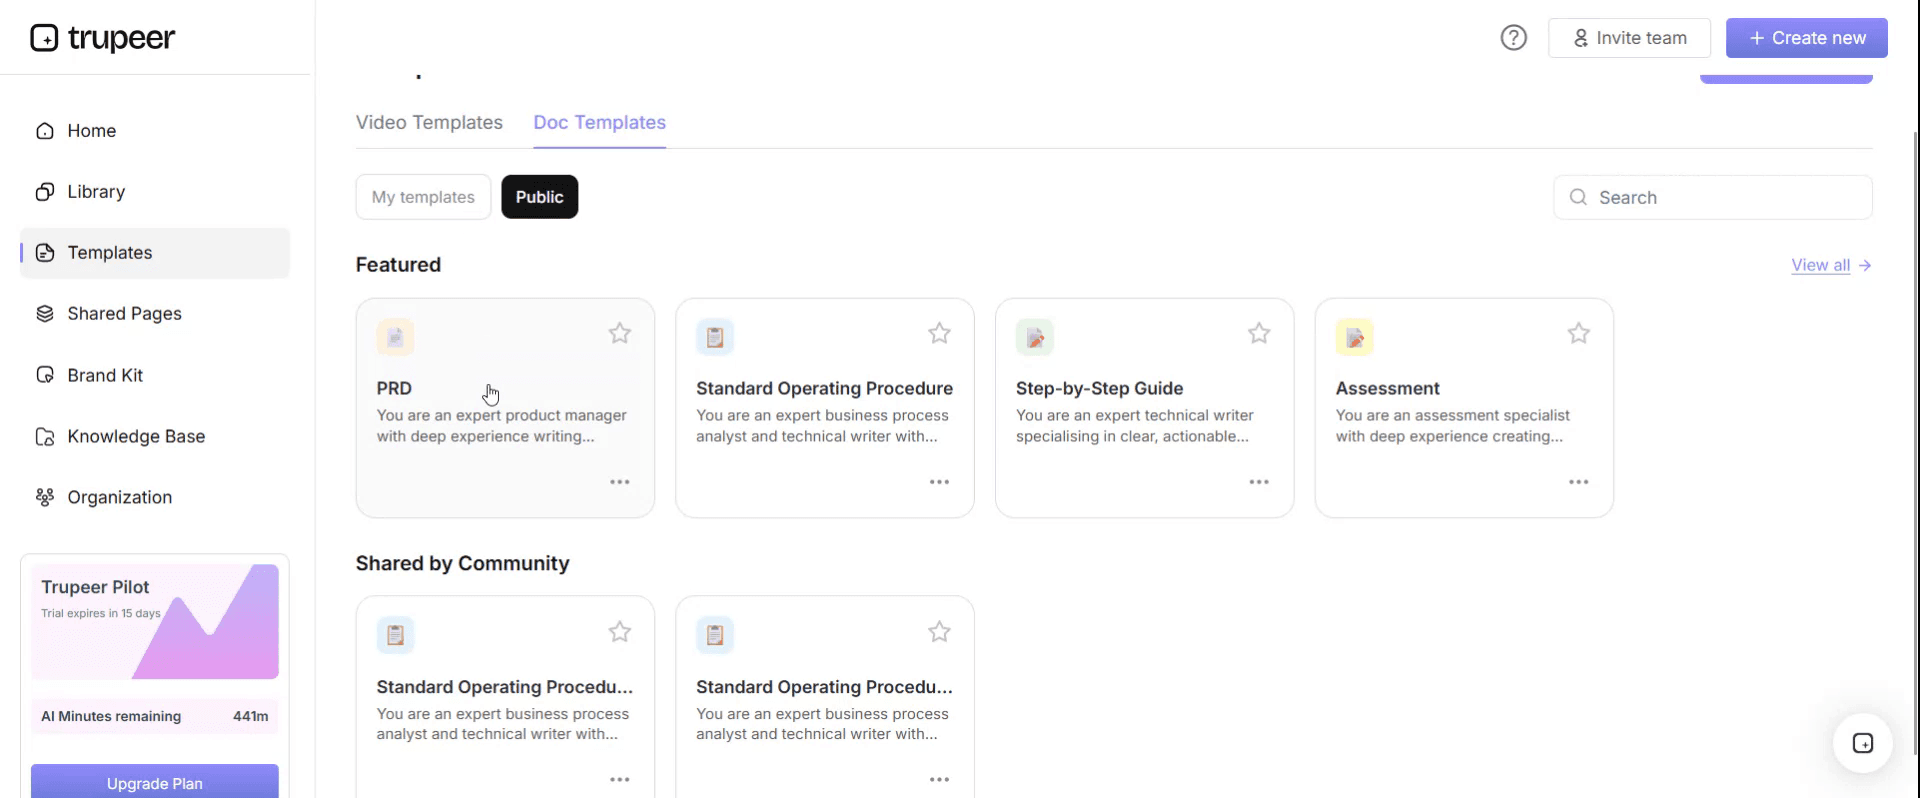
Passo 2: Selecionar e abrir um modelo
Clique em qualquer modelo com que queira trabalhar para o abrir.
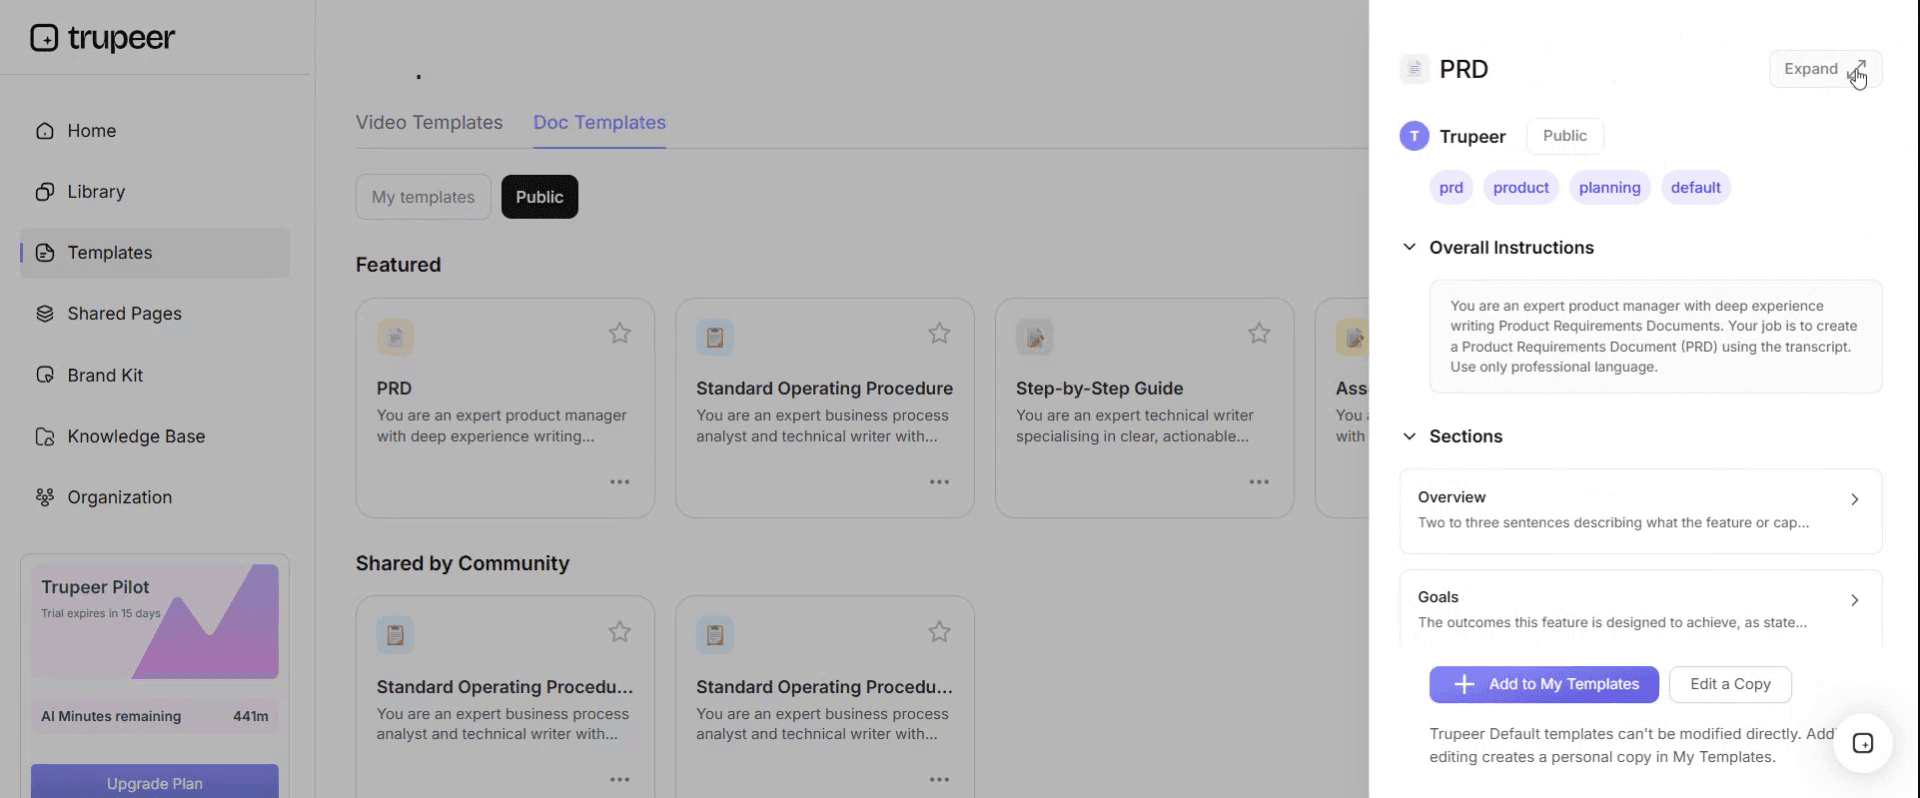
Passo 3: Expandir a visualização do modelo
Se necessário, expanda a visualização do modelo para ver o layout completo e os detalhes com clareza.
Passo 4: Editar o modelo
Clique em Editar para começar a modificar o modelo selecionado.
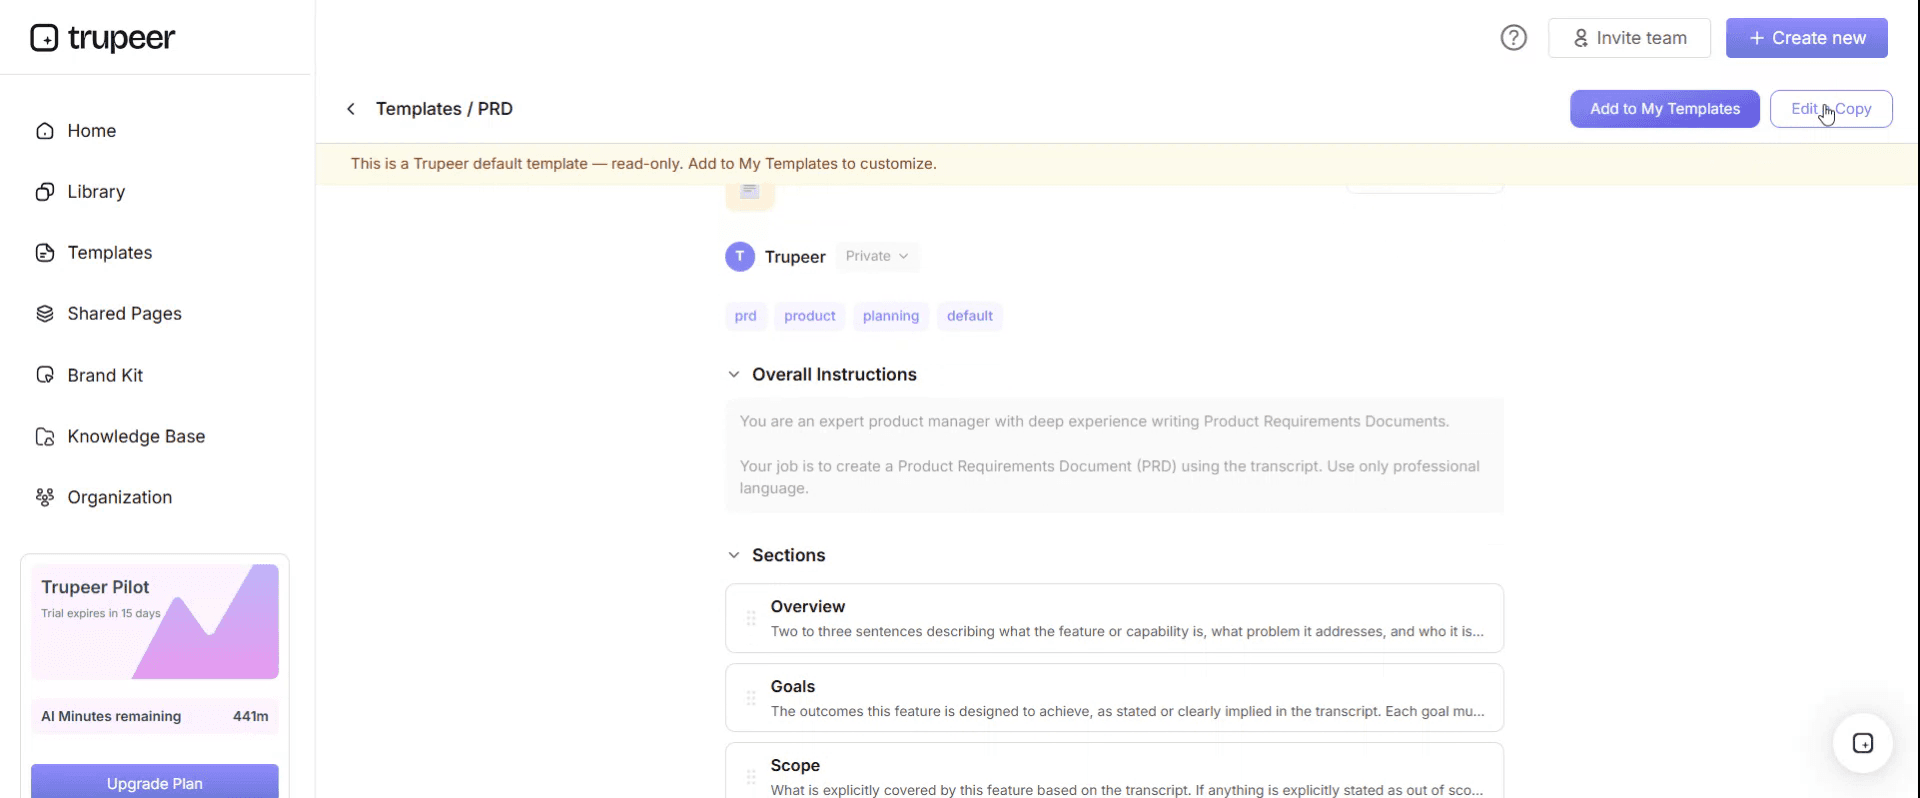
No editor, pode:
Adicionar novas secções
Definir ou atualizar regras de formatação
Adicionar um logótipo e ajustar a sua posição e definições relacionadas
Passo 5: Guardar o seu modelo personalizado
Depois de fazer todas as alterações necessárias, clique em Guardar para guardar o modelo atualizado como seu.
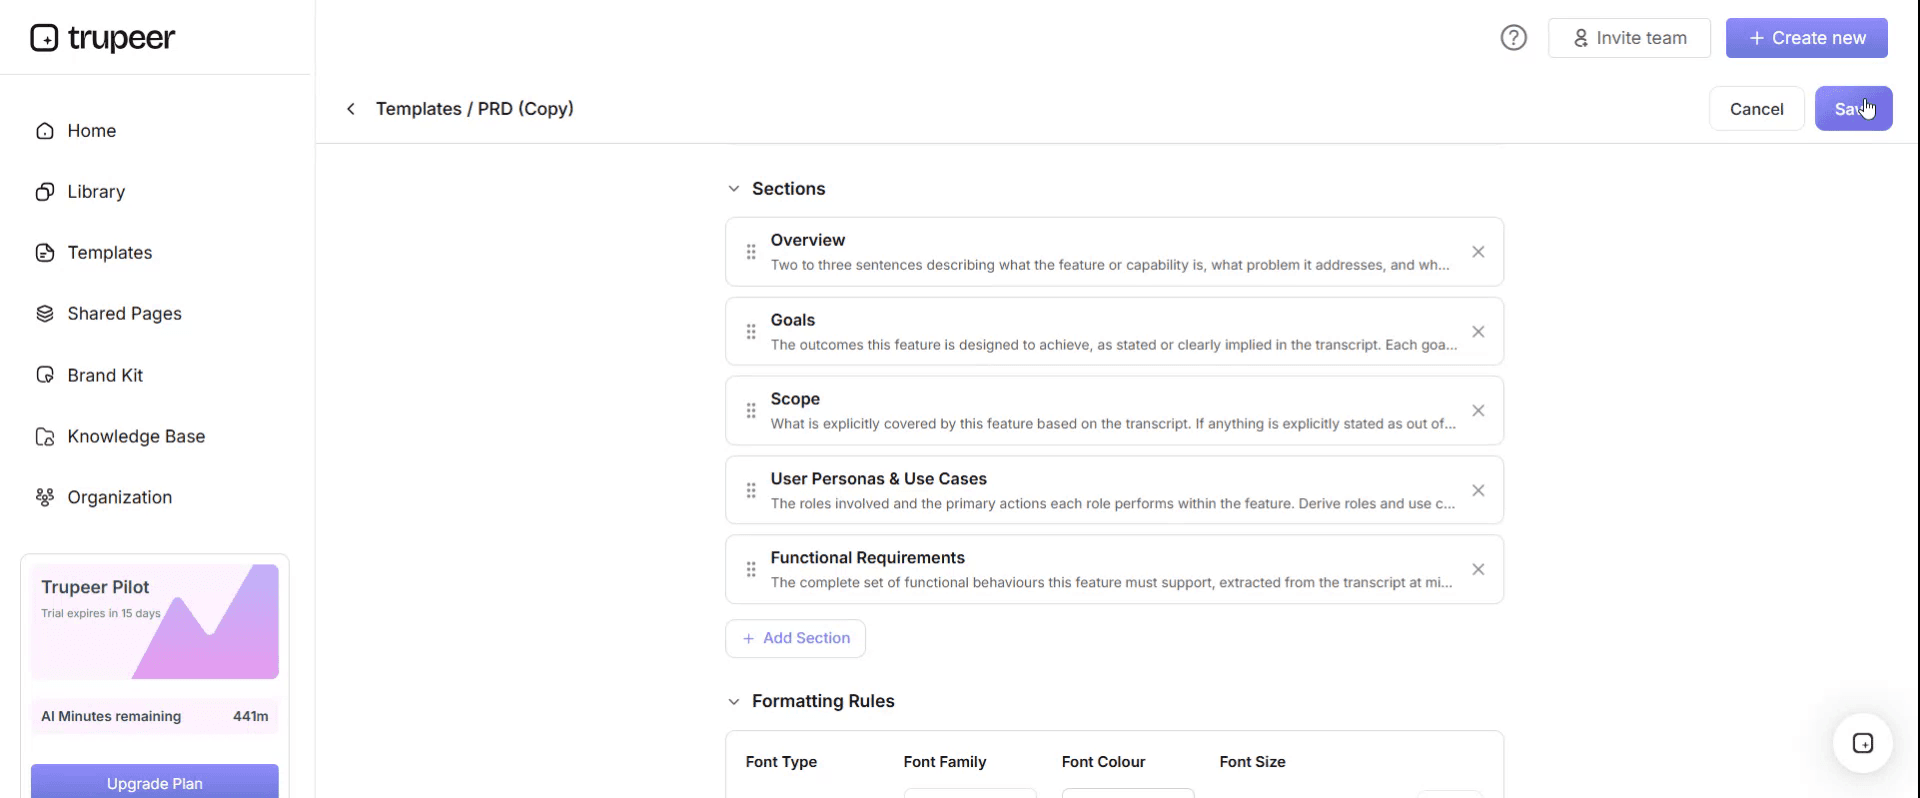
Passo 6: Pré-visualizar e afinar o modelo
Quando quiser ver como fica o seu modelo personalizado, abra a Pré-visualização.
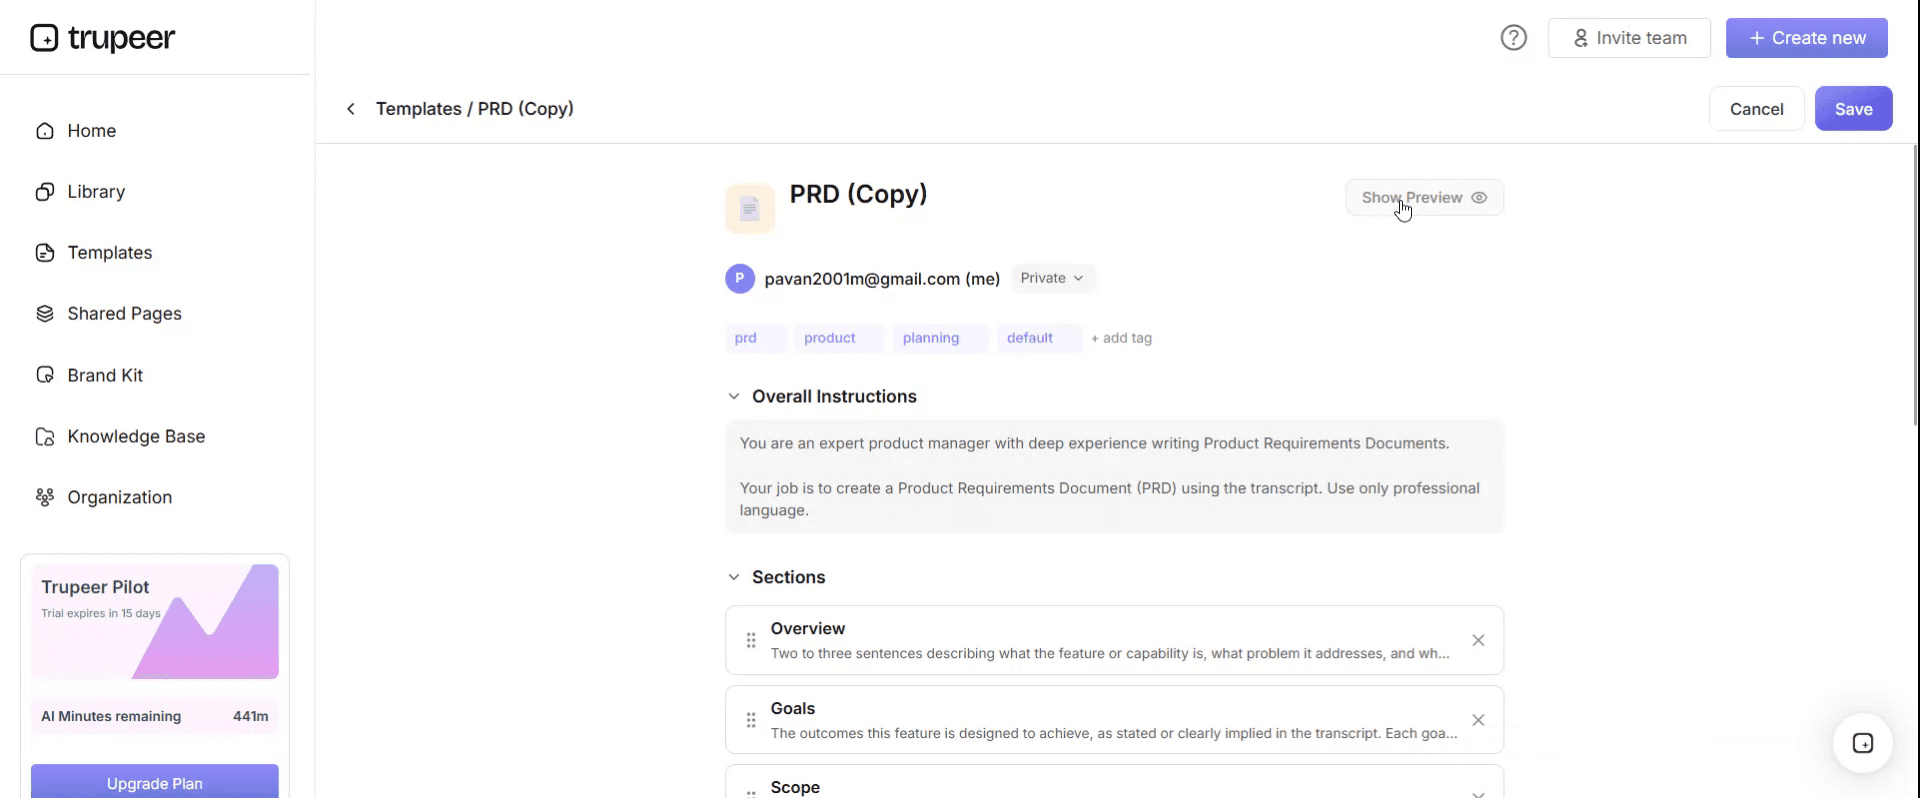
A partir do ecrã de pré-visualização, pode continuar a fazer ajustes diretamente, se necessário, garantindo que o modelo aparece exatamente como o quer.
Com um modelo de base de conhecimento, pode:
Poupar horas na configuração: Evite a página em branco com uma estrutura criada para bases de conhecimento.
Reduzir os pedidos de suporte: Conteúdo claro e pesquisável ajuda os utilizadores a resolverem sozinhos.
Manter-se alinhado com a marca: Aplique o seu logótipo, fontes e cores usando o kit de marca da Trupeer.
Adicionar walkthroughs em vídeo: Combine artigos com tutoriais em vídeo incorporados.
Uniformizar o conteúdo: Use os mesmos modelos de artigos para uma qualidade consistente.
Atingir utilizadores globais: Traduza o conteúdo da base de conhecimento para 65+ idiomas com um clique.
A regra de admissão que vem antes de qualquer estrutura de categorias
A maioria das equipas desenha primeiro a árvore de categorias. Essa é a ordem errada, porque a árvore depende do que se admite e uma árvore desenhada para material de referência vai-se encher de “restos” de projetos assim que ninguém estiver a vigiar.
Escreva primeiro a regra de admissão, publique-a e coloque-a no modelo que aparece quando alguém cria uma página. Três perguntas, e todas têm de ser “sim”.
Alguém vai precisar disto, mesmo não estando na sala? Se o público são as quatro pessoas que já estão na conversa, é uma mensagem, não um artigo.
Continuará a ser verdade daqui a seis meses? Qualquer coisa com uma data associada, um número de sprint ou um evento específico pertence à ferramenta que “detém” esse assunto, e não aqui.
É o único lugar onde isto vive? Se a versão autoritativa é um contrato, um ticket, um repositório ou uma folha de cálculo, ligue para isso. Uma cópia na base de conhecimento fica errada no momento em que o original muda, e uma cópia errada é pior do que nenhuma porque parece estar a ser mantida.
Qualquer coisa que falhe uma das três vai para outro lado. Não é apagada, e não é discutida: é movida para um espaço que é excluído da pesquisa na base de conhecimento.
O que pertence a uma base de conhecimento e o que não pertence
Pertence | Vai para outro lado | Para onde vai |
|---|---|---|
Respostas a perguntas recorrentes | Notas de reuniões | Um espaço de reuniões, excluído da pesquisa |
Procedimentos e SOPs | Documentos de trabalho do projeto | A ferramenta do projeto, arquivada no fecho |
Políticas atuais | Políticas substituídas | Um espaço de arquivo com um banner visível |
Valores de referência, códigos, limites | Qualquer coisa com uma data ou um número de sprint | A ferramenta que “detém” o calendário |
Percursos de onboarding por função | Notas pessoais e rascunhos | Um espaço pessoal |
Problemas conhecidos e soluções alternativas | Contratos, faturas, tickets | Os seus sistemas de registo, ligados e não copiados |
Decisões registadas e o porquê | Apresentações em slides | Onde quer que as apresentações vivam, com a decisão escrita aqui |
A linha sobre a qual as pessoas discutem são as notas de reuniões. Parecem conhecimento e são a maior fonte de diluição da pesquisa em qualquer base de conhecimento interna que eu tenha visto descrita. Mantenha-as, mantenha-as encontráveis para a equipa que as escreveu e mantenha-as fora do índice da base de conhecimento.
Modelo de base de conhecimento gratuito: a estrutura de categorias para copiar
Sete categorias de topo, sem sub-sub-categorias, com nomes que refletem o que o leitor está a fazer, em vez de qual equipa é responsável pelo conteúdo.
Começar. Percursos ordenados por função, cada um com um estado final. Novo colaborador, novo administrador, novo cliente.
Como fazer. Instruções de tarefas para pessoas que já sabem o que querem fazer.
Resolução de problemas. Entradas por sintoma, e não por sistema.
Políticas e regras. O que é obrigatório e o que não é permitido, com um responsável e uma data de entrada em vigor em cada uma.
Referência. Valores, códigos, limites, limiares e contactos. Principalmente tabelas.
Sistemas e acesso. Para que serve cada ferramenta, quem pode obtê-la e como pedir.
Problemas conhecidos. Problemas atuais, soluções alternativas e a data da última atualização.
Adapte os nomes, mantenha a contagem. Duas regras fazem com que isto se mantenha. Nenhuma categoria tem o nome de uma equipa, porque os leitores não conhecem o seu organigrama e reorganizações deixam seções inteiras “órfãs”. E nada fica no nível de topo fora destas sete, porque a primeira exceção é sempre seguida por mais nove.
Deve existir uma base de conhecimento ou duas?
Duas, em quase todos os casos, e a divisão é por público, e não por tema. Os clientes ficam com uma. A equipa fica com outra. O mesmo assunto pode aparecer nas duas, escrito de forma diferente.
Tentar servir ambos a partir de uma única base produz o pior de cada um. Ou os detalhes internos “vazam” para o conteúdo dirigido a clientes, ou a versão interna é despojada das ressalvas, dos caminhos de escalonamento e das limitações conhecidas que a tornam útil para um agente. As equipas de suporte acabam por manter um documento privado do que os artigos públicos deixam de fora, o que é o sinal mais claro de que a divisão era necessária e nunca foi feita.
Onde as duas se ligam é na passagem de responsabilidade. Um artigo interno sobre um problema recorrente deve ligar ao artigo dirigido a clientes para o qual o agente vai apontar, e os seus modelos de resposta do help desk devem referenciar o artigo público em vez de o repetir.
Um exemplo de base de conhecimento: 6.400 páginas e ninguém conseguia pesquisar
Havenlark, uma empresa de software com cerca de quatrocentas pessoas, geria a sua base de conhecimento interna num wiki. Em 2022, tinha aproximadamente novecentas páginas e um inquérito interno colocou a satisfação com a pesquisa nos setenta e um por cento.
Três anos depois, tinha cerca de seis mil e quatrocentas páginas e a satisfação com a pesquisa tinha caído para vinte e quatro por cento. As equipas de IT e de pessoas estavam a responder às mesmas perguntas que tinham documentado anos antes.
Uma auditoria ordenou as páginas. Cerca de duas mil e cem eram notas de reuniões. Mil e quatrocentas eram páginas de projetos para projetos que tinham terminado. Novecentas eram rascunhos duplicados ou abandonados. Seiscentas eram espaços pessoais “rascunho”. Isso deixou cerca de mil e quatrocentas páginas que, em teoria, eram material de referência, das quais cerca de novecentas eram atuais.
O conteúdo de referência não tinha diminuído. Tinha quase exatamente o mesmo tamanho de 2022. Tornou-se invisível. Ao pesquisar a política de despesas, surgiram trinta e quatro resultados, dos quais trinta e um eram notas de reuniões que mencionavam despesas de passagem.
A correção não escreveu conteúdo novo nenhum. Duas pessoas passaram uma semana a mover notas de reuniões, páginas de projetos e espaços pessoais para áreas separadas excluídas do índice de pesquisa da base de conhecimento e colocaram um banner nas políticas substituídas. Nada foi apagado, o que permitiu fazê-lo rapidamente e sem discussões.
O inquérito seguinte colocou a satisfação com a pesquisa nos sessenta e três por cento.
Há duas coisas que vale a pena retirar disso. O problema nunca foi a autoria, por isso nenhuma quantidade de escrita o teria resolvido. E a recuperação demorou uma semana porque o conteúdo ainda estava todo lá, o que é o argumento para mover em vez de apagar quando herda uma base de conhecimento neste estado.
Quem é o responsável por uma base de conhecimento e como é atribuída a responsabilidade
Cada categoria tem um responsável nomeado. Não uma equipa, porque um responsável de equipa significa que ninguém verifica, e não uma função de documentação, porque não conseguem avaliar se o conteúdo continua a ser verdade.
O trabalho do responsável é pequeno e específico: confirmar duas vezes por ano que a categoria continua a corresponder à realidade, aprovar ou recusar novas páginas de topo na sua área e arquivar o que foi substituído. Meio dia, duas vezes por ano, e a pessoa que o faz deve ser quem quer que responda a perguntas sobre esse assunto, de qualquer forma.
Acima dos sete responsáveis, existe uma pessoa responsável pelo contentor em si, ou seja, a regra de admissão, a configuração da pesquisa e o arquivo. Este é o papel onde as bases de conhecimento normalmente têm uma lacuna, porque parece que não é trabalho de ninguém até a pesquisa deixar de funcionar. Quando o “património” é suficientemente grande para exigir um tratamento mais formal, o nosso modelo de gestão do conhecimento cobre o ciclo de vida e a captura em vários sistemas.
Como configurar um modelo de base de conhecimento em duas semanas
A primeira semana é de subtração. Se estiver a herdar uma base existente, execute a auditoria acima: organize tudo em “pertence” e “vai para outro lado” e, depois, mova em vez de apagar. Se estiver a começar do zero, escreva a regra de admissão e obtenha acordo, porque concordar com ela depois de o conteúdo já existir é muito mais difícil.
A segunda semana é de estrutura. Crie as sete categorias, nomeie os sete responsáveis e “semente” cada uma com as três perguntas que a sua equipa realmente faz com mais frequência, obtidas da sua fila de tickets ou do seu canal de suporte, e não de uma sessão de brainstorming.
Depois, pare. Uma base de conhecimento que é lançada com vinte e uma páginas genuinamente úteis e uma regra sobre o que vem a seguir vai vencer uma que é lançada com duzentas páginas importadas, todas as vezes, e continuará a ser utilizável daqui a três anos.
Modelos de website da base de conhecimento, temas HTML e escolha da plataforma
Algumas pessoas que procuram um modelo de base de conhecimento gratuito querem um website: um tema HTML ou um centro de ajuda alojado, em vez de uma estrutura de conteúdo. Essa é uma necessidade real e distinta, e aparece diretamente nestes resultados, com um resumo de temas para programadores a classificar na mesma pesquisa.
As duas decisões são independentes e apenas uma delas afeta se as pessoas encontram respostas. Um centro de ajuda com tema e sem regra de admissão enche-se do mesmo “lixo” que um wiki. O que realmente importa numa plataforma é a qualidade da pesquisa: se consegue excluir espaços do índice, a granularidade das permissões e como é apresentada num telemóvel. A aparência é a menos relevante das quatro e a mais fácil de alterar mais tarde.
Se está a escolher onde a base de conhecimento vai viver, teste a pesquisa num volume realista de conteúdo antes de qualquer outra coisa. A maioria das demonstrações de plataformas usa cinquenta páginas perfeitas, o que não lhe diz nada sobre como a pesquisa se comporta com quatro mil.
Posso obter um modelo de base de conhecimento gratuito em Word ou PDF?
A estrutura de categorias, a regra de admissão e a tabela “pertence” acima foram escritas para serem coladas no Word ou no Google Docs e usadas como documento de configuração. Esse documento vale a pena manter, porque é a coisa para a qual aponta quando alguém pergunta porque é que as suas notas de reuniões foram movidas.
O PDF é adequado para a versão que distribui uma vez que a estrutura é acordada. O que não funciona em nenhum dos formatos é a própria base de conhecimento. Uma base de conhecimento é definida por ser pesquisável e uma pasta de ficheiros Word é uma unidade partilhada com passos extra.
O que torna o melhor modelo de base de conhecimento gratuito para a sua equipa
Não é o número de categorias nem o polimento do layout. Avalie um modelo de base de conhecimento em três aspetos: se lhe diz o que deve manter fora, se cada área tem um responsável humano nomeado e se sobrevive à saída de alguém.
A maioria dos catálogos de modelos gratuitos de base de conhecimento oferece uma árvore de categorias e nada mais, que é a parte mais fácil de desenhar e a menos preditiva de se aquilo funciona no terceiro ano. Se um modelo não menciona arquivamento, não pensou no problema que, na prática, destrói as bases de conhecimento.
Como preencher uma nova base de conhecimento sem um projeto de conteúdo
A diferença entre acordar a estrutura e ter algo dentro dela é onde a maioria das bases de conhecimento fica bloqueada. Sete categorias vazias são um compromisso que ninguém tem tempo para cumprir e o projeto de conteúdo para as preencher é agendado duas vezes e cancelado duas vezes.
A Trupeer AI fecha essa lacuna ao transformar uma gravação do ecrã num artigo finalizado, pelo que a pessoa que sabe a resposta grava-se a fazer a tarefa uma vez e edita em vez de escrever. Vinte e uma páginas “seed” passam a ser uma tarde, em vez de um quarto.
Registe. Marque a marca. Traduza. Trupeer.
A mesma gravação dá-lhe um guia escrito, um vídeo e um documento para a sua base de conhecimento com uma marca consistente, e a tradução significa que uma estrutura serve todas as regiões, em vez de cada uma começar silenciosamente a sua própria. Para documentação técnica, aplica-se o mesmo, e as instruções de configuração estão no guia de configuração do modelo de documento.
Perguntas Frequentes
Existe um modelo de base de conhecimento gratuito em Word?
A estrutura acima é colada diretamente no Word ou no Google Docs como o seu documento de configuração e governação, cobrindo categorias, responsáveis e a regra de admissão. Não existe download com acesso restrito e não existe formulário. Os próprios artigos não devem viver no Word, porque uma base de conhecimento é definida pela pesquisa e os ficheiros Word não são pesquisáveis de forma útil.
Existe um modelo de base de conhecimento gratuito em PDF?
Exporte o seu próprio assim que as sete categorias e os nomes dos responsáveis estiverem acordados e distribua-o como versão de referência. Mantenha a cópia de trabalho editável, já que a regra de admissão normalmente precisa de um ajuste após o primeiro mês de argumentos reais sobre o que pertence.
Posso descarregar um modelo de base de conhecimento gratuito?
A estrutura de categorias, a regra de admissão, a tabela “pertence” e o modelo de responsabilidade são gratuitos e sem restrições. Use-os, renomeie as categorias para se adequarem à sua organização e coloque-os nos seus próprios documentos de governação sem necessidade de atribuição.
Qual é a diferença entre uma base de conhecimento e um wiki?
Um wiki é uma tecnologia em que qualquer pessoa pode criar e editar páginas. Uma base de conhecimento é um propósito, ou seja, um conjunto curado de respostas com responsáveis e uma regra de admissão. A maioria das bases de conhecimento falhadas são wikis que nunca receberam a segunda metade, que é exatamente o padrão da Havenlark acima.
Com quantos artigos deve começar uma base de conhecimento?
Cerca de vinte, escolhidos a partir das perguntas que a sua equipa ou os seus clientes realmente fizeram com mais frequência no mês passado. Começar com mais é o erro mais comum, porque o conteúdo importado chega sem responsáveis e define o precedente de que tudo pode ser adicionado, que é o precedente que está a tentar não estabelecer.
A nossa base de conhecimento deve ser pública ou ficar atrás de um login?
Pública para tudo o que um cliente potencial possa pesquisar, porque esses artigos fazem dupla função como aquisição. Atrás de um login para tudo o que identifica sistemas internos, caminhos de escalonamento, limiares ou pessoal nomeado. Se um artigo precisar de ambos os tratamentos, esse é o sinal mais claro de que precisa de duas bases de conhecimento em vez de uma com permissões complicadas.
Com que frequência deve ser revista uma base de conhecimento?
Os responsáveis das categorias confirmam a sua área duas vezes por ano, o que é suficiente para a estrutura. Os artigos individuais devem ser revalidado com base em gatilhos, e não num calendário, ou seja, quando um ticket é aberto apesar de o artigo já existir ou quando o que ele descreve muda. Rever o contentor e rever o conteúdo são tarefas separadas em relógios separados.


