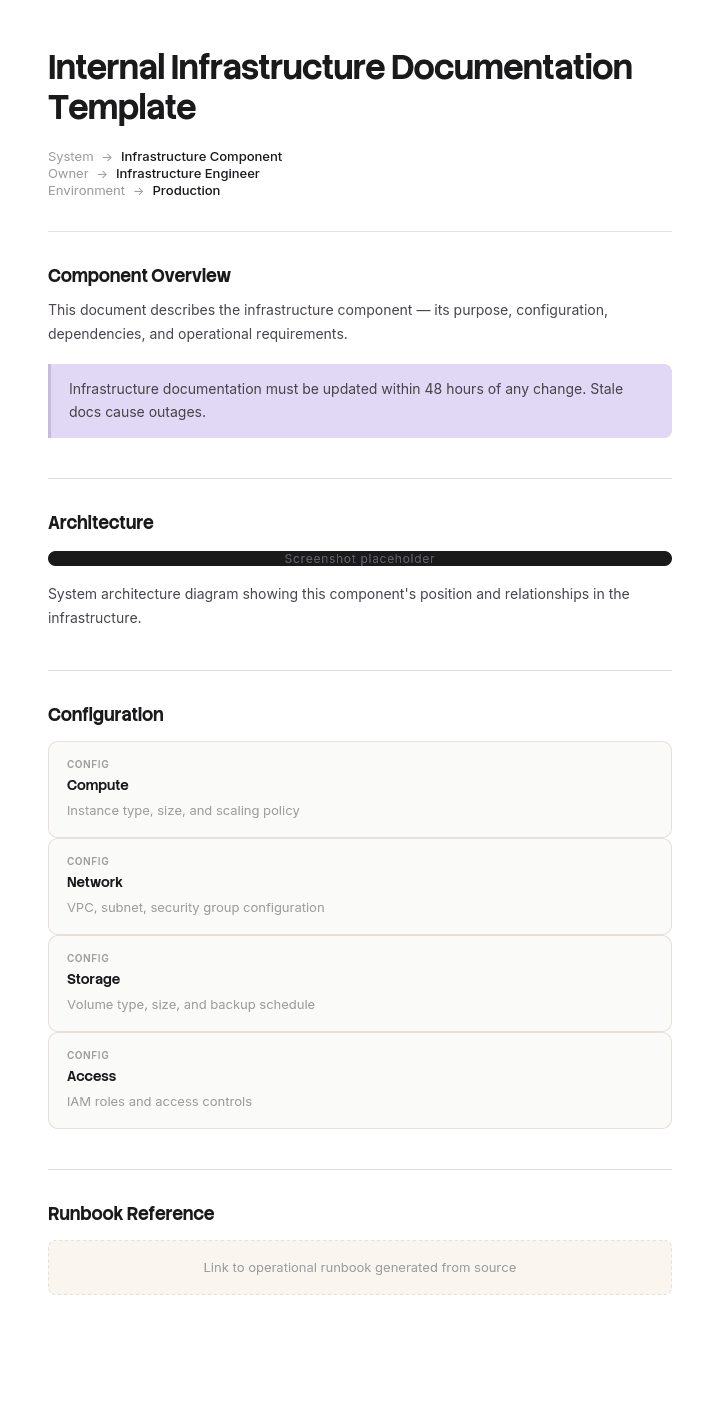
Use este modelo
Uma documentação interna sólida da infraestrutura protege a sua empresa contra falhas, auditorias e incidentes de segurança. Com a Trupeer, pode poupar horas na documentação da infraestrutura começando com um modelo gratuito, personalizando-o com as suas diretrizes de marca e transformando a documentação em walkthroughs em vídeo para equipas de TI e MSPs.
A maior parte da documentação da infraestrutura é escrita uma vez, durante um projeto, e fica errada em seis meses. Fica na wiki, ninguém confia nela e, durante o próximo incidente, alguém lê, hesita e telefona a pessoa que realmente sabe.
A solução não é mais documentação. É menos documentação que se mantém verdadeira, escolhida perguntando o que alguém precisaria mesmo às três da manhã.
Descarregue o modelo de documentação da infraestrutura
Formato | Melhor para |
|---|---|
Excel (.xlsx) | O inventário, a matriz de dependências, os detalhes de rede e o registo de revisões |
Word (.docx) | Runbooks, visão geral da arquitetura e o plano de DR |
Versões aprovadas e tudo o que os auditores pedem | |
Google Sheets | Um inventário partilhado que a equipa mantém |
Google Docs | Runbooks que são editados durante e após incidentes |
Gratuito, editável, sem marca de água. O Excel faz aqui a maior parte do trabalho, porque a documentação da infraestrutura é, em grande medida, dados estruturados a fingir que são prosa.
Que documentação precisa?
Precisa de documentar | Utilize |
|---|---|
O que existe na infraestrutura e como se liga | Este modelo |
Processos de TI, políticas e procedimentos “como fazer” em geral | |
Um projeto específico | |
Um produto de software para os seus utilizadores | |
Um procedimento de TI | |
Arquitetura e design de software |
Como personalizar este modelo na Trupeer
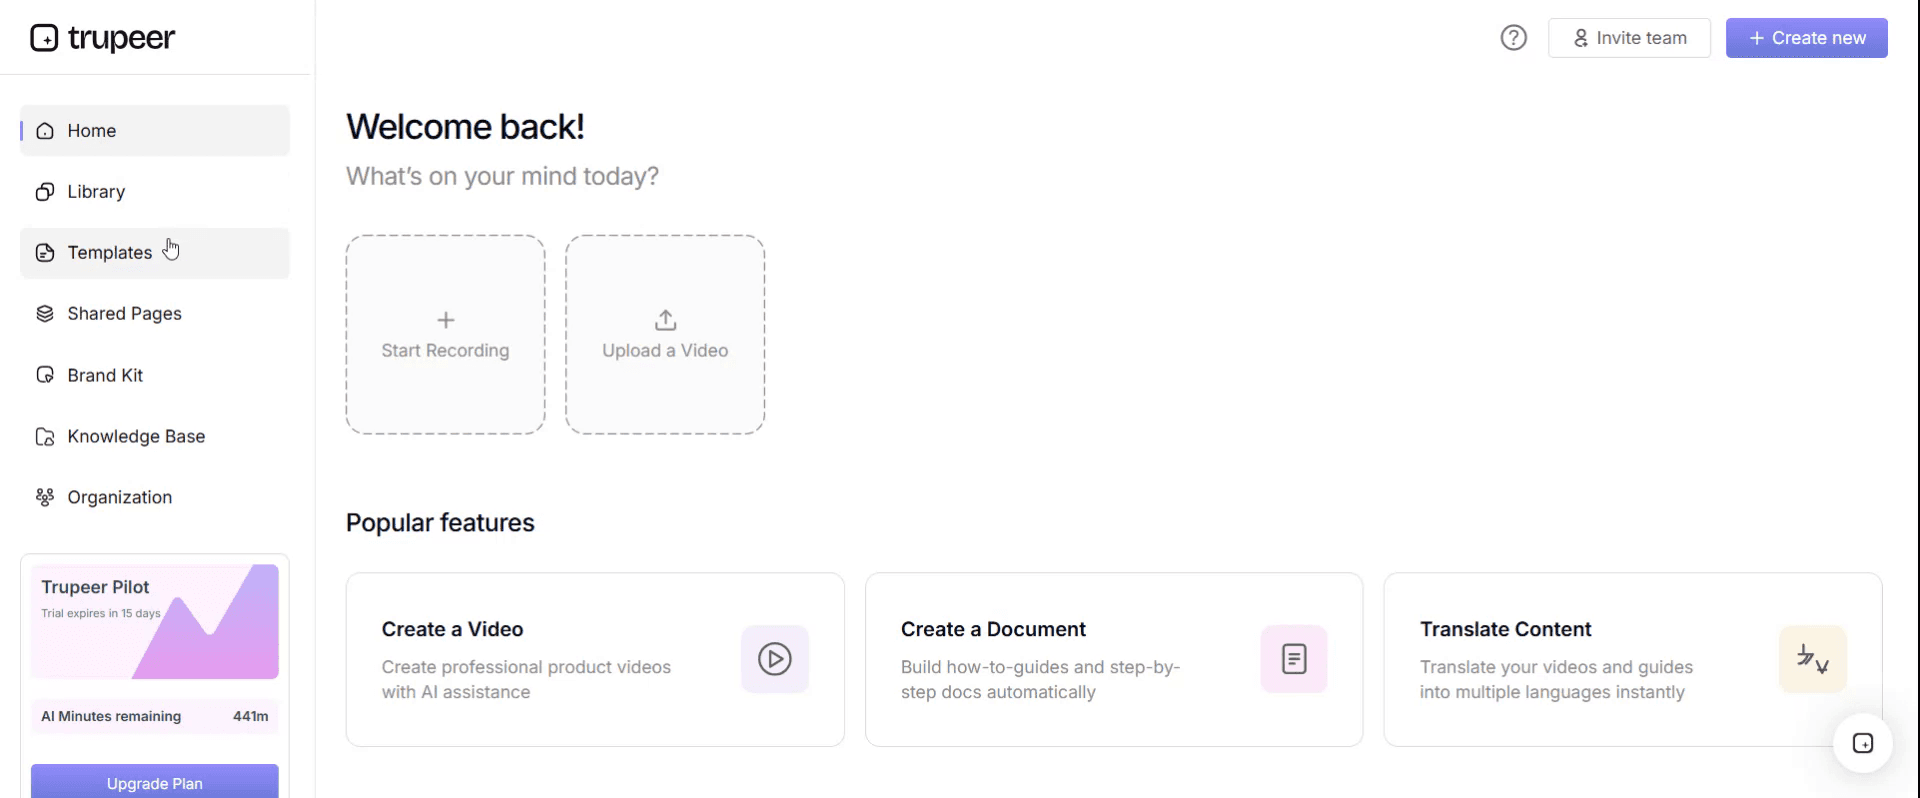
Passo 1: Abra a secção de Modelos
Vá à secção de Modelos no menu principal.
Passo 2: Selecione e abra um modelo
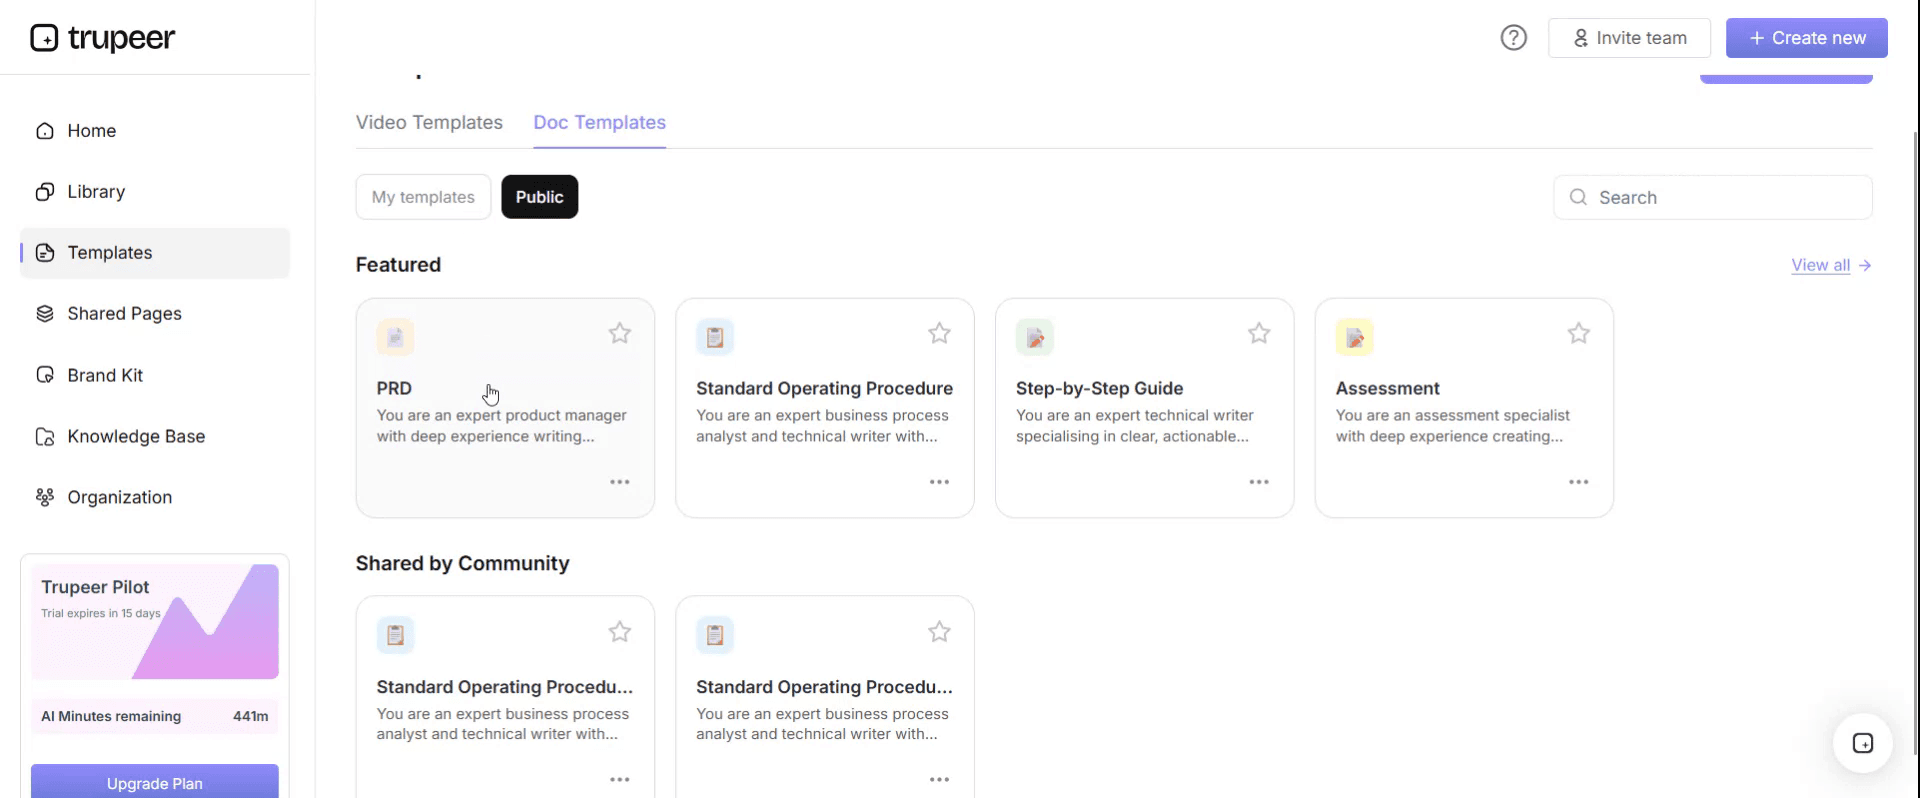
Clique em qualquer modelo com que queira trabalhar para o abrir.
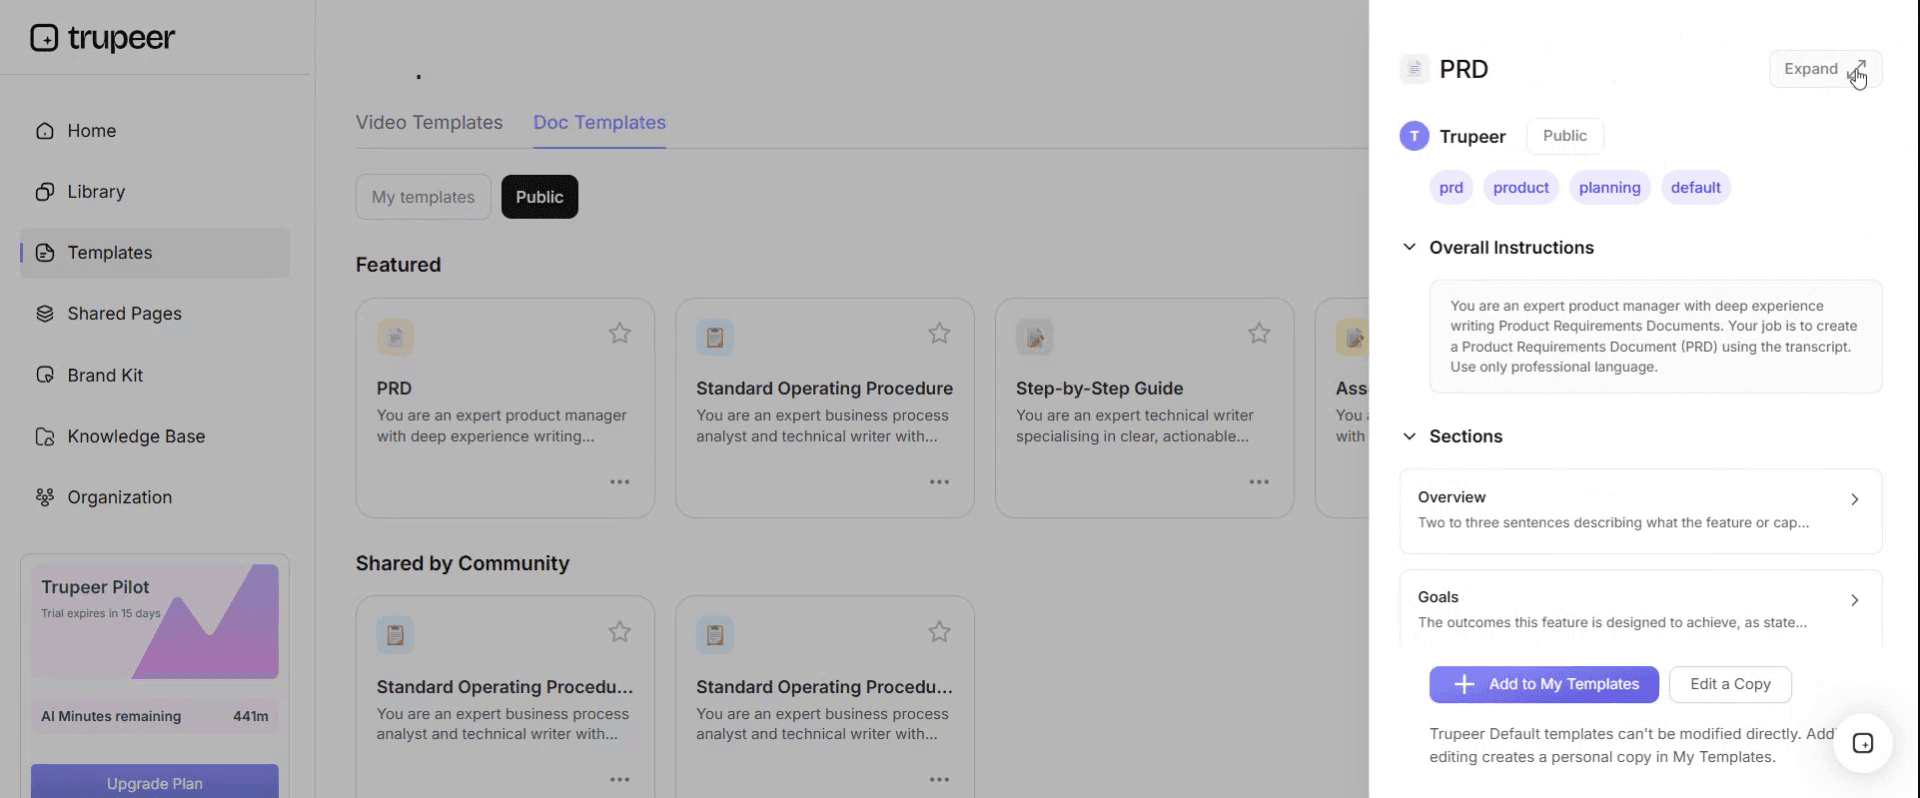
Passo 3: Expanda a visualização do modelo
Se necessário, expanda a visualização do modelo para ver o layout completo e os detalhes de forma clara.
Passo 4: Edite o modelo
Clique em Editar para começar a modificar o modelo selecionado.
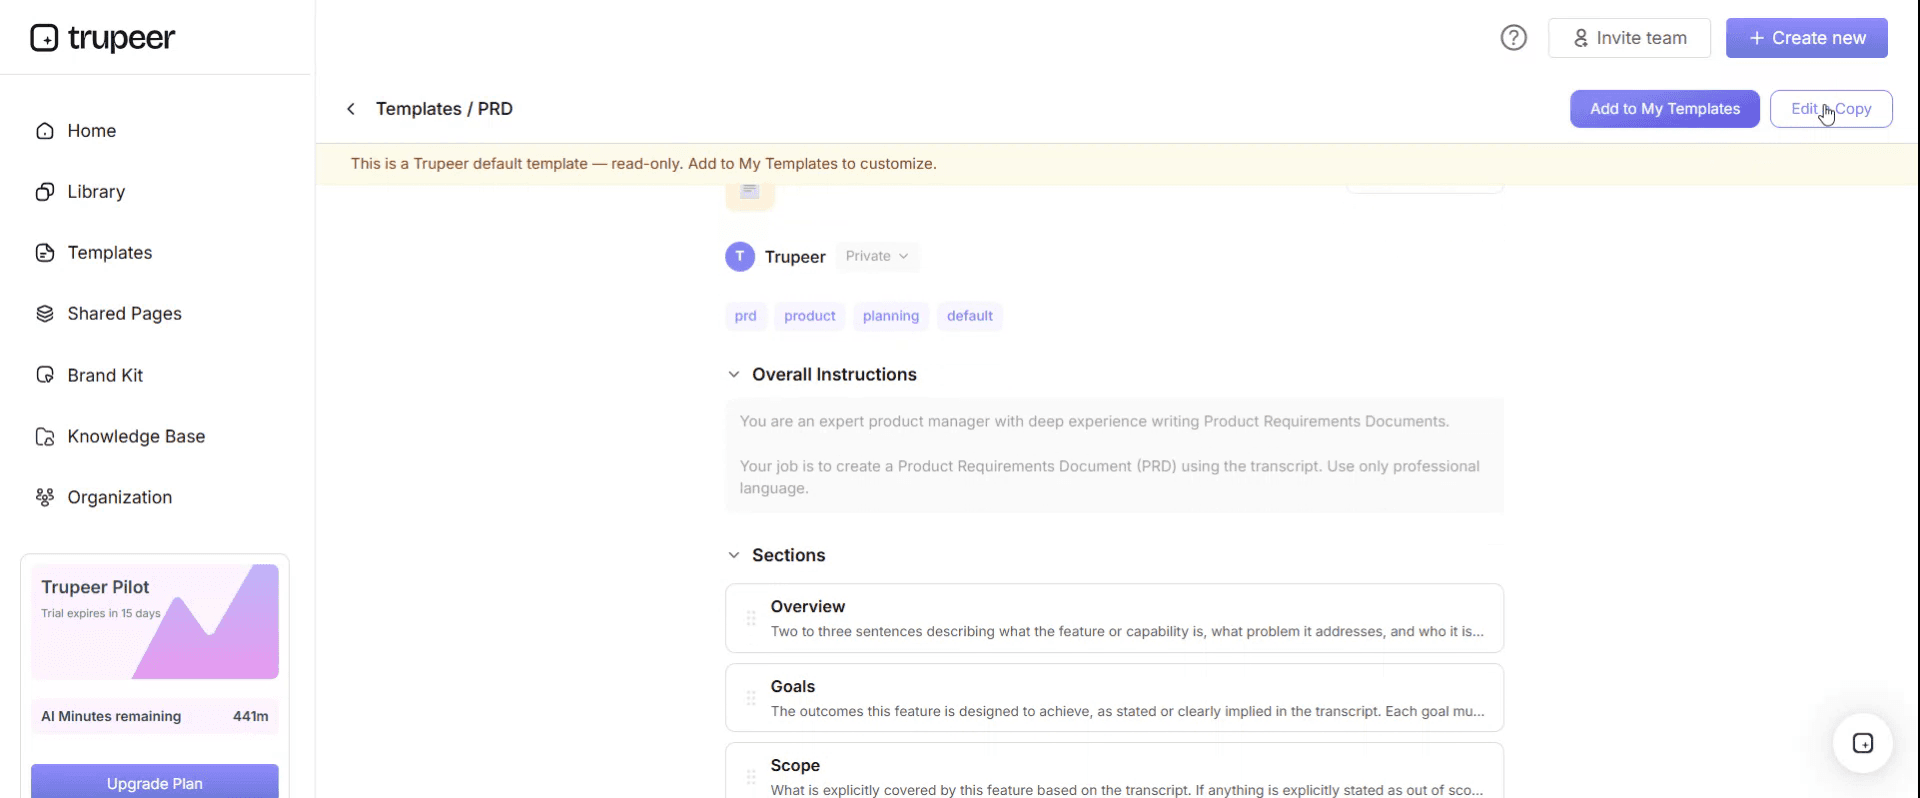
No editor, pode:
Adicionar novas secções
Definir ou atualizar regras de formatação
Adicionar um logótipo e ajustar a sua posição e definições relacionadas
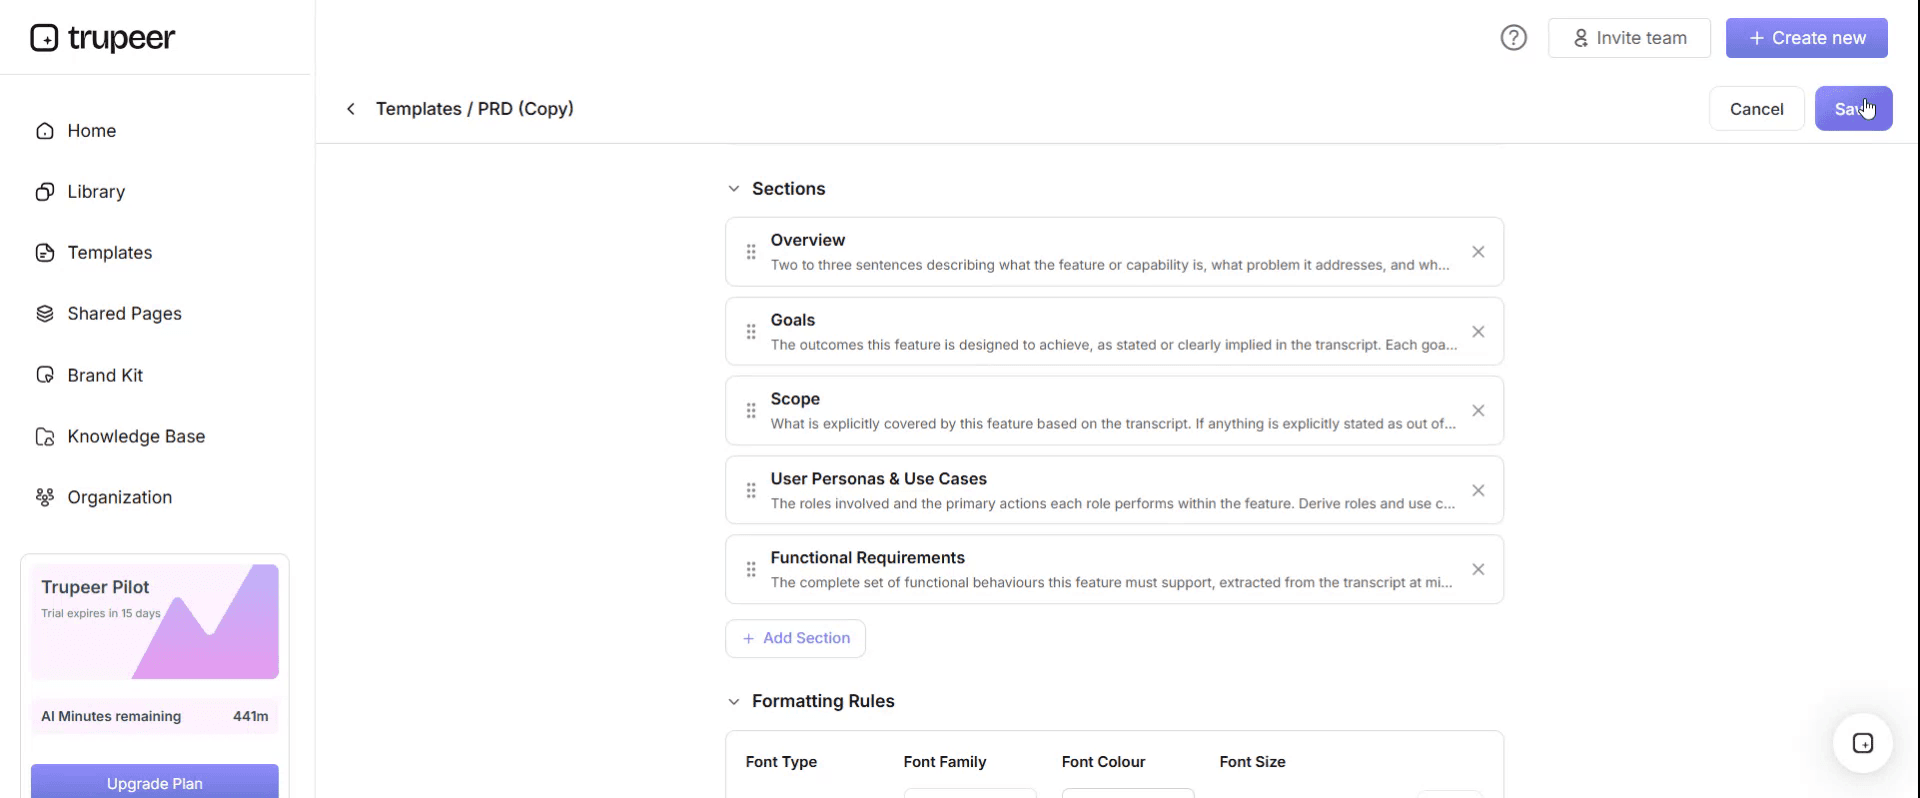
Passo 5: Guarde o seu modelo personalizado
Depois de fazer todas as alterações necessárias, clique em Guardar para guardar o modelo atualizado como seu.
Passo 6: Pré-visualize e ajuste o modelo
Quando quiser ver como fica o seu modelo personalizado, abra a Pré-visualização.
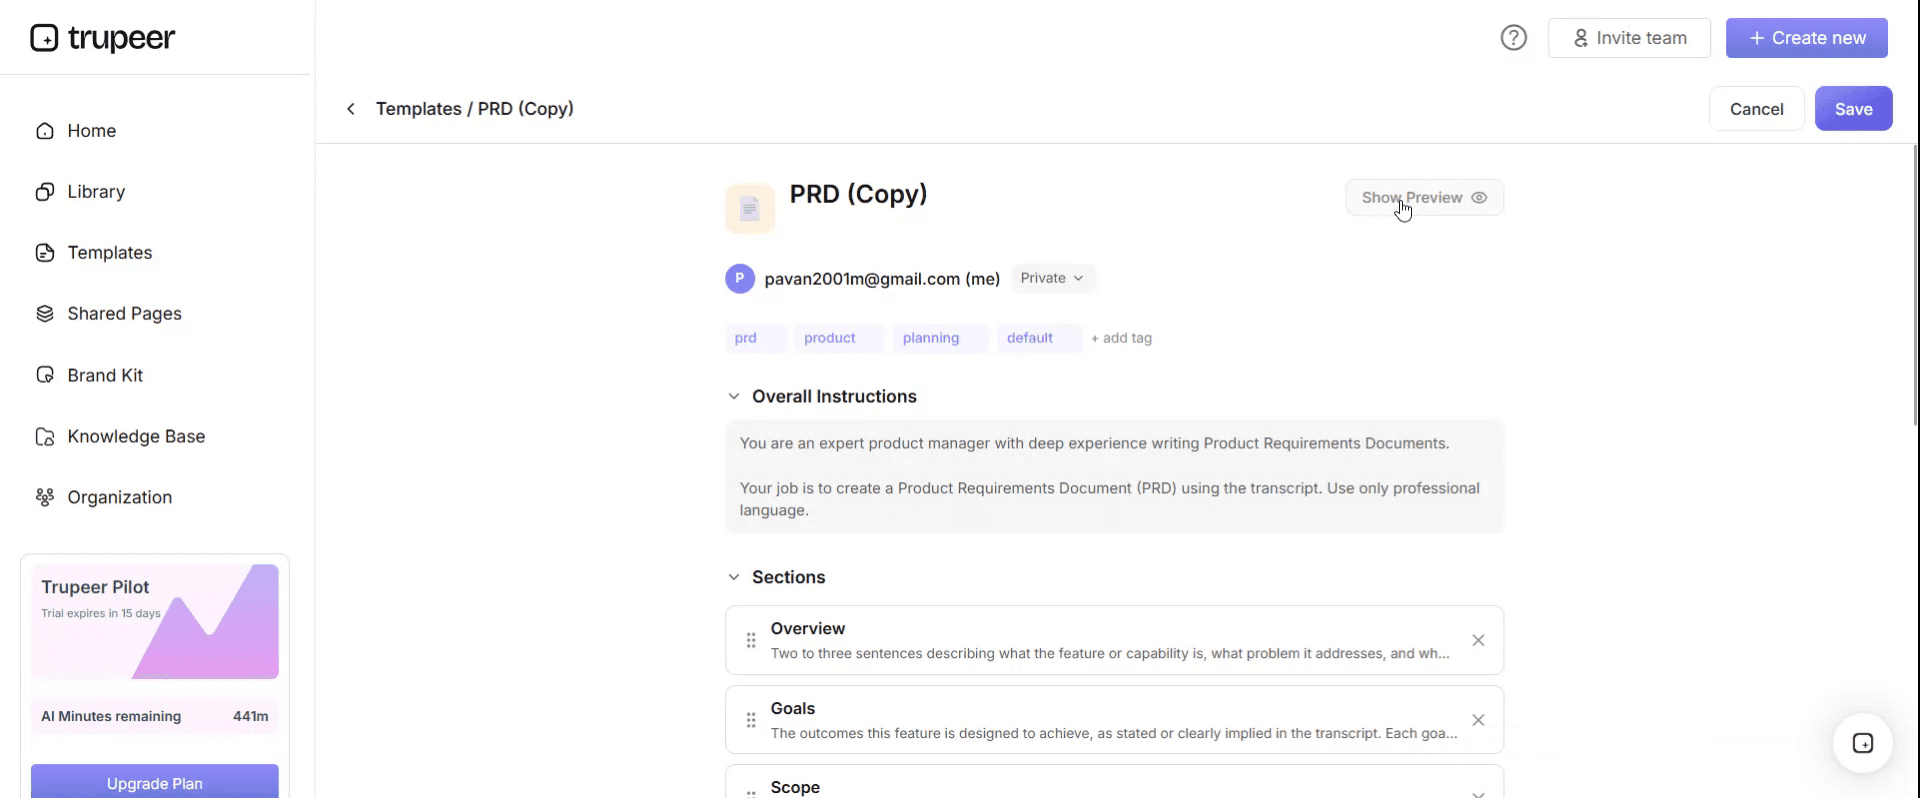
A partir do ecrã de pré-visualização, pode continuar a fazer ajustes diretamente, se necessário, garantindo que o modelo aparece exatamente como o pretende.
Com um modelo de documentação interna da infraestrutura, pode:
Poupar horas na escrita: Ignore a página em branco com uma estrutura criada para a infraestrutura de TI.
Melhorar a postura de segurança: Campos integrados obrigam a práticas seguras de gestão de credenciais.
Manter-se alinhado com a marca: Aplique o seu logótipo, fontes e cores com o kit de marca da Trupeer.
Reduzir o tempo de inatividade: Uma documentação clara reduz o MTTR durante incidentes.
Manter-se pronto para auditorias: Alinhado com a SOC 2, ISO 27001 e frameworks semelhantes.
Atingir equipas globais: Traduza a documentação para 65+ idiomas com um clique.
O teste das 3 da manhã
O único teste que importa para a documentação da infraestrutura.
Imagine um incidente às três da manhã. A pessoa que construiu o sistema está num avião. Alguém competente, mas sem familiaridade, está a consultar a sua documentação. Consegue perceber o que está avariado, de que depende, o que acontece se o reiniciar e a quem deve escalar?
Tudo o que ajuda nisso vale a pena escrever. O resto é opcional e a documentação opcional é o que dilui as partes úteis e consome o orçamento de manutenção.
Aplique-o sem piedade. Um histórico detalhado de por que uma tecnologia foi escolhida em 2021 não passa. Uma nota a dizer que este serviço tem de ser iniciado depois da base de dados e antes do gateway de API também não passa.
O que passa no teste das 3 da manhã
O que existe. Sistemas, servidores, serviços, com o que cada um faz numa frase.
Onde está. Fornecedor de cloud e região, ou localização física e rack.
O que depende disso e do que depende. A coisa mais valiosa na documentação da infraestrutura.
Como chegar a isso. Nomes de anfitrião, endereços, consolas, embora nunca credenciais.
Como é o “normal”. Para que uma pessoa sem familiaridade consiga perceber se algo está realmente errado.
O que o faz falhar. Modos de falha conhecidos e os respetivos sintomas.
Como reiniciá-lo em segurança, incluindo a ordem e o que tem de ser feito primeiro.
Quem é o responsável, e o caminho de escalonamento com dados de contacto reais.
Qual é o raio de impacto. O que falha se isto falhar.
O que normalmente não passa
Escrito para a completude em vez de para o uso e, por isso, não vale a pena manter.
Despejos completos de configuração que ficam obsoletos no dia seguinte à exportação. Racional detalhado de decisões passadas, que pertence a um registo de decisão de arquitetura em vez de documentação operacional. Todos os parâmetros de todos os sistemas quando, operacionalmente, só alguns importam. Capturas de ecrã de consolas, que envelhecem mal e raramente ajudam. E tudo o que duplica uma fonte de verdade noutro lugar, porque duas cópias significam que uma está errada e não consegue dizer qual.
O princípio geral: se puder ser descoberto a partir do sistema mais depressa do que pode ser lido num documento, não o documente.
O inventário da infraestrutura
A base. Uma linha por sistema ou serviço.
Campo | Introduza |
|---|---|
Nome | Como aparece na monitorização e na conversa |
Finalidade | Uma frase, em linguagem simples |
Tipo | Servidor, serviço, base de dados, dispositivo de rede, SaaS |
Ambiente | Produção, staging, desenvolvimento |
Localização | Fornecedor de cloud e região, ou site e rack |
Responsável | Equipa e um contacto de escalonamento identificado |
Criticidade | Nível 1 a 3, definido abaixo |
Depende de | O que precisa para funcionar |
É utilizado por | O que falha se parar |
Método de acesso | Consola, bastion SSH, VPN. Não credenciais |
Monitorização | Para onde vão os alertas |
Cópia de segurança | Frequência, localização, última reposição verificada |
Runbook | Ligação |
Última verificação | Data em que alguém confirmou que esta linha é verdadeira |
O último campo é o que a maioria dos inventários omite e o que determina se alguém confia no documento. Uma linha que ninguém verificou há dois anos deve ser visivelmente pouco confiável, em vez de estar silenciosamente errada.
Níveis de criticidade
Defina-os, porque determinam quanto de documentação cada sistema merece.
Nível | Significa | Documentação esperada |
|---|---|---|
1 | A falha para o negócio | Runbook completo, DR testado, mapa de dependências, revisto trimestralmente |
2 | A falha degrada uma função | Runbook, dependências, revisto duas vezes por ano |
3 | A falha é tolerável durante um dia | Apenas entrada no inventário e responsável |
A maioria das organizações documenta o nível 3 com a mesma profundidade do nível 1, sem energia para continuar e acaba com tudo documentado a meio. Faça o nível 1 corretamente e deixe o nível 3 como uma única linha.
Dependências
A parte mais valiosa e mais negligenciada da documentação da infraestrutura.
Durante um incidente, a pergunta raramente é o que está avariado. É o que mais é afetado e o que esta coisa precisa para voltar. Nenhuma das duas coisas é descobrível a partir de uma lista de servidores.
Documente as dependências em ambos os sentidos:
Sistema | Depende de | É utilizado por | Ordem de arranque | Falha se a dependência estiver em baixo |
|---|---|---|---|---|
Order API | Postgres primário, Redis, serviço de autenticação | Aplicação web, aplicação móvel, integrações com parceiros | Depois do Postgres e da Auth | Sim, imediatamente |
Reporting service | Replica do Postgres | Apenas dashboards internos | Qualquer | Degrada, serve dados em cache |
Duas coisas tornam isto útil. A ordem de arranque, porque reiniciar coisas na sequência errada transforma um incidente curto num longo. E se a dependência é “hard” ou “soft”, já que um serviço que degrada de forma controlada é um problema muito diferente de um que falha imediatamente.
Inclua dependências externas. Fornecedores de pagamento, fornecedores de identidade, DNS, autoridades de certificados e APIs de SaaS causam falhas que não consegue resolver e saber isso rapidamente vale muito às três da manhã.
Documentação de rede
Elemento | Documente |
|---|---|
Segmentos de rede | Finalidade, intervalo de endereços, VLAN |
Roteamento | Entre segmentos e para a internet |
Firewalls | Onde estão, quem gere as regras e como solicitar uma alteração |
VPN | Endpoints, quem tem acesso e como solicitar |
DNS | Zonas, onde estão alojadas e quem as pode alterar |
Balanceadores de carga | O que está por trás de cada um, comportamento de health check |
Certificados | O que cobrem, validade, responsável pela renovação e método |
Conectividade externa | ISPs, circuitos, contactos, referências contratuais |
A expiração dos certificados merece uma atenção própria. Provoca falhas totalmente previsíveis, totalmente evitáveis e desproporcionadamente prováveis de acontecerem ao fim de semana. Documente o que expira quando, quem renova e se a renovação é automatizada.
Runbooks
O documento que alguém abre mesmo durante um incidente.
Secção | Conteúdo |
|---|---|
Sistema e responsável | Com contacto de escalonamento |
O que este sistema faz | Um parágrafo |
Como é o “normal” | Métricas, comportamento esperado, carga típica |
Alertas comuns | O que significa cada um e o que fazer |
Como reiniciar em segurança | Passos, ordem, pré-requisitos |
Modos de falha conhecidos | Sintoma, causa, correção |
O que não fazer | As ações que pioram as coisas |
Escalonamento | Quando e para quem |
Runbooks relacionados | Dependências |
A secção “o que não fazer” é rara e valiosa. Todos os sistemas maduros têm uma ação que parece razoável e piora o incidente: reiniciar na ordem errada, limpar uma cache que demora seis horas a reconstruir, fazer failover quando o secundário está atrás.
Escreva runbooks para sistemas de nível 1 e para tudo o que tenha causado um incidente. Não para tudo.
Acesso e credenciais
A secção onde a documentação causa danos em vez de os prevenir.
Nunca coloque credenciais na documentação. Não palavras-passe, não chaves de API, não strings de ligação com segredos incorporados, não chaves privadas. Não na wiki, não no ficheiro Excel, não “temporariamente”.
Documente o método de acesso. Qual sistema detém a credencial, quem pode conceder acesso e como alguém a solicita às 3 da manhã. É isso que a pessoa realmente precisa e é seguro escrever.
Em vez de | Documentar |
|---|---|
A palavra-passe de admin | Credenciais em [vault], acessíveis à equipa da plataforma, procedimento de “break-glass” em [runbook] |
Uma chave de API | Chave guardada em [secrets manager] como [name], rodada trimestralmente por [owner] |
Um login partilhado | Acesso via grupo SSO [name], pedido através de [process] |
Depois, documente corretamente o procedimento de “break-glass”, porque o acesso de emergência indisponível durante uma emergência é uma falha comum e evitável.
Recuperação após desastre
O que a documentação de DR tem de conter para valer alguma coisa.
Objetivos de tempo de recuperação e de ponto de recuperação por sistema de nível 1, acordados com o negócio em vez de assumidos pela TI. O que o procedimento de recuperação é, de facto, passo a passo. Onde estão as cópias de segurança e, criticamente, quando foi a última vez que uma reposição foi testada com sucesso. Quem declara um desastre e quem ativa o plano. Como a equipa comunica quando os sistemas normais estão indisponíveis, já que um plano de DR guardado apenas nos sistemas que estão em baixo é uma vergonha familiar.
A linha mais importante em qualquer documento de DR é a data do último teste de reposição bem-sucedido. Uma cópia de segurança que nunca foi reposta é uma hipótese.
Diagramas
A infraestrutura beneficia de diagramas mais do que a maioria da documentação e eles ficam obsoletos mais depressa.
Um diagrama de alto nível que mostre os principais componentes e como se ligam. Este é o que as pessoas realmente usam.
Topologia de rede, onde o ambiente é suficientemente complexo para precisar disso.
Fluxo de dados, especialmente onde atravessa fronteiras de confiança ou jurisdições.
Mantenha-os simples. Um diagrama que ninguém consegue ler de relance durante um incidente é decoração.
Datem-nos, e coloquem o responsável no diagrama.
Prefira diagramas como código onde a sua equipa o vai manter, porque um diagrama num formato de texto com controlo de versões é atualizado com a alteração em vez de ser atualizado depois.
Um diagrama errado é pior do que nenhum diagrama, porque as pessoas confiam mais em imagens do que em prosa.
Manter tudo preciso
O problema completo e a razão pela qual a maior parte da documentação da infraestrutura falha.
Documente menos. A precisão cresce de forma inversa com o volume. Quinze páginas precisas valem mais do que duzentas obsoletas.
Associe as atualizações da documentação ao processo de alteração. Uma alteração que muda a infraestrutura não está completa até a documentação refletir isso. Este é o único mecanismo que funciona de forma fiável.
Automatize o que pode ser descoberto. Inventário, endereços, configurações e topologia podem muitas vezes ser gerados. A documentação gerada não fica obsoleta do mesmo modo que a documentação escrita à mão.
Escreva à mão apenas o que não pode ser descoberto. Finalidade, responsabilidade, criticidade, dependências, modos de falha conhecidos, o que não fazer. As máquinas não conseguem inferir nada disso.
Datas em tudo, e mostre a data de forma evidente. Uma data de última verificação visível permite aos leitores calibrar a sua confiança.
Revise por agenda consoante o nível, trimestralmente para o nível 1.
Corrija durante os incidentes. O momento em que alguém descobre que a documentação está errada é o momento em que já tem o conhecimento para a corrigir. Faça disso uma tarefa de cinco minutos, não um ticket.
Automação e descoberta
Vale o investimento, porque elimina o maior modo de falha.
Bases de dados de gestão de configuração, inventários de fornecedores de cloud, repositórios de infraestrutura como código e ferramentas de descoberta de rede podem gerar continuamente informação atual e precisa do estado. Tudo o que conseguirem produzir não deve ser mantido manualmente.
A divisão que funciona: as máquinas documentam o que existe, os humanos documentam o que isso significa. Um inventário gerado automaticamente diz-lhe que um servidor existe e o que está instalado nele. Só uma pessoa consegue dizer-lhe que é aquele que não deve ser reiniciado entre as 2 da manhã e as 4 da manhã por causa do batch run.
Quando a infraestrutura é definida como código, o código é a documentação do que existe. O que falta escrever é a intenção, o conhecimento operacional e os modos de falha.
Quem é o responsável
Atribua a responsabilidade por sistema em vez de tornar a documentação um trabalho de uma única pessoa, que nunca sobrevive à saída dessa pessoa.
A equipa que opera um sistema é responsável pela respetiva documentação. Um indivíduo identificado é responsável pelo padrão geral, pelos modelos e pela cadência de revisão. E o processo de alteração obriga a atualizações, porque a responsabilidade sem um mecanismo é apenas uma intenção.
O padrão de falha é um responsável pela documentação que anda a perseguir toda a gente. Funciona durante cerca de dois meses.
Testar a documentação
O equivalente a um teste de reposição e igualmente negligenciado.
Pegue numa pessoa que não construiu o sistema, dê-lhe apenas a documentação e peça-lhe que complete uma tarefa operacional de rotina. Um reinício controlado, um failover, uma reposição para um ambiente de teste.
Tudo o que não consegue fazer a partir da documentação é uma lacuna. Tudo o que faz mal é um defeito. Isto é desconfortável e é a única forma fiável de saber se a documentação funcionaria às 3 da manhã, já que a pessoa que a escreveu consegue sempre preencher as lacunas com memória.
Faça isto, pelo menos uma vez por ano, para sistemas de nível 1, idealmente como parte de um game day ou de um exercício de DR.
Boas práticas
Aplique o teste das 3 da manhã a tudo antes de escrever.
Documente o nível 1 corretamente e o nível 3 de forma mínima.
Dependências em ambos os sentidos, com ordem de arranque.
Nunca credenciais, sempre métodos de acesso.
Data de última verificação em cada registo.
Automatize tudo o que pode ser descoberto; escreva à mão apenas a intenção e o conhecimento operacional.
Atualizações da documentação impostas pelo processo de alteração.
Os runbooks incluem o que não fazer.
Testes de reposição com datas no plano de DR.
Teste a documentação com alguém sem familiaridade, anualmente.
Erros comuns
Credenciais na wiki.
Tudo documentado com a mesma profundidade, para que nada seja mantido.
Dependências documentadas apenas num sentido.
Sem ordem de arranque, pelo que a recuperação demora mais do que a falha.
Despejos de configuração que ficam obsoletos à chegada.
Diagramas sem data e sem responsável, confiáveis muito tempo depois de deixarem de ser verdade.
Documentação como entrega de um projeto, nunca atualizada depois.
Uma pessoa, nominalmente responsável por tudo.
Planos de DR guardados na infraestrutura que cobrem.
Cópias de segurança documentadas, reposições nunca testadas.
Sem data de última verificação, pelo que os leitores não conseguem avaliar o que confiar.
Escrita pela pessoa que a construiu, testada por ninguém.
Capture o que só a pessoa que o construiu sabe
Abra os modelos no Trupeer AI, aplique o seu kit de marca para que a documentação corresponda aos seus padrões e edite qualquer secção diretamente. A configuração está no guia do modelo.
A automação cobre o que existe. O que não consegue captar é o conhecimento operacional: a ordem pela qual as coisas voltam, a verificação que faz antes de fazer failover e a razão pela qual ninguém reinicia esse serviço numa terça-feira.
Esse conhecimento vive com uma ou duas pessoas e desaparece quando elas saem. Peça-lhes que expliquem um failover ou uma reposição enquanto gravam e o Trupeer AI produz o runbook escrito e um walkthrough em vídeo narrado a partir da mesma sessão, na ordem em que realmente o fazem, em vez da ordem que se lembrariam de escrever.
E também ocupa menos do tempo delas do que escrever, o que é importante, porque a razão pela qual o conhecimento operacional fica sem documentação é que as pessoas que o têm estão sempre ocupadas. Traduza-o para 65+ idiomas para equipas distribuídas e mantenha o conjunto na sua base de conhecimento, ao lado dos runbooks.
Registe. Dê marca. Traduza. Trupeer.
Perguntas Frequentes
Existe um modelo gratuito de documentação da infraestrutura em Word?
Sim. O Word guarda os runbooks, a visão geral da arquitetura e o plano de DR, as partes que são genuinamente narrativas. Descarregamento gratuito, sem registo, sem marca de água.
Existe um modelo gratuito de documentação da infraestrutura em Excel?
Sim, e o Excel faz a maior parte do trabalho. Inclui o inventário do sistema com níveis de criticidade e datas de última verificação, a matriz de dependências em ambos os sentidos, detalhes de rede, o controlo da expiração de certificados e o calendário de revisões.
Existe um modelo gratuito de documentação da infraestrutura em PDF?
Sim, em versões aprovadas e para tudo o que um auditor ou cliente pede para ver. Mantenha as cópias de trabalho editáveis, já que a documentação da infraestrutura que não pode ser atualizada rapidamente não é atualizada.
Posso descarregar um modelo gratuito de documentação da infraestrutura?
Sim, todos os formatos são descarregamentos gratuitos, sem necessidade de conta e sem atribuição.
Existem modelos gratuitos de documentação de TI?
Sim. Esta página aborda especificamente a infraestrutura. Para documentação de TI de forma mais abrangente, incluindo processos, políticas e material “como fazer”, consulte Exemplos e modelos de documentação de TI e, para procedimentos de TI, o modelo de SOP de TI.
Existe um modelo de documentação de TI em Word?
Sim, na página de exemplos e modelos de documentação de TI. Esta página é mais específica, cobrindo os sistemas, redes e dependências que compõem a sua infraestrutura.
Existe um modelo de documentação de projeto em Word, gratuito para descarregar?
Sim, na página do modelo de documentação de projeto. A documentação de projeto cobre o âmbito, o plano e as entregas de um projeto, enquanto a documentação da infraestrutura cobre o que existe em produção, independentemente de qual projeto o tenha construído.
O que é a documentação de infraestrutura de TI?
Um registo dos sistemas, redes, serviços e dependências que compõem o seu ambiente, juntamente com o conhecimento operacional necessário para os executar e recuperar. Cobre o que existe, de que depende o quê, como é o “normal” e como responder quando algo falha.
O que deve incluir a documentação da infraestrutura?
Um inventário de sistemas com responsáveis e criticidade, dependências em ambos os sentidos com ordem de arranque, detalhes de rede e conectividade, runbooks para sistemas críticos, métodos de acesso mas nunca credenciais, detalhes de cópias de segurança e recuperação após desastre, incluindo o último teste de reposição bem-sucedido, e uma data de última verificação em tudo.
Como é que mantém a documentação da infraestrutura atualizada?
Documente menos, automatize tudo o que pode ser descoberto e associe as atualizações da documentação ao seu processo de alteração para que uma alteração não fique completa até a documentação refletir isso. Coloque uma data de última verificação visível em cada registo, reveja por nível de criticidade, e deixe que qualquer pessoa corrija erros imediatamente em vez de abrir um ticket.
As credenciais devem ser guardadas na documentação?
Não. Não palavras-passe, chaves de API, strings de ligação ou chaves privadas, em qualquer sistema, temporariamente ou de outra forma. Documente em vez disso qual vault ou gestor de segredos detém a credencial, quem pode conceder acesso e o procedimento de “break-glass” para emergências. É isso que alguém realmente precisa durante um incidente e é seguro escrever.
Quanto da infraestrutura deve documentar?
O suficiente para passar no teste das 3 da manhã para sistemas críticos e muito pouco para o resto. Os sistemas de nível 1 precisam de runbooks completos, mapas de dependências e DR testado. Os sistemas de nível 3 precisam de uma linha de inventário e de um responsável. Documentar tudo com a mesma profundidade é a razão pela qual a maior parte da documentação da infraestrutura acaba obsoleta.
O que é um runbook?
Um documento operacional para um sistema, cobrindo como é o “normal”, o que significam alertas comuns, como o reiniciar em segurança incluindo ordem e pré-requisitos, modos de falha conhecidos, o que não fazer e quando escalar. É o que alguém abre durante um incidente e deve ser escrito para uma pessoa competente que não esteja familiarizada com esse sistema específico.
Como é que documenta dependências?
Em ambos os sentidos, porque durante um incidente precisa de saber tanto o que este sistema exige como o que falha se ele parar. Inclua a ordem de arranque, se cada dependência é “hard” ou “soft” e dependências externas como fornecedores de identidade, DNS e processadores de pagamento, que causam falhas que não consegue resolver por si.
Com que frequência deve ser revista a documentação da infraestrutura?
Por nível de criticidade: trimestralmente para o nível 1, duas vezes por ano para o nível 2 e em cada alteração para o nível 3. Para além de revisões agendadas, o processo de alteração deve obrigar a atualizações e qualquer pessoa que descubra um erro durante um incidente deve conseguir corrigi-lo imediatamente.
Como sei se a minha documentação funciona mesmo?
Teste-a. Dê a alguém que não construiu o sistema apenas a documentação e peça-lhe que execute uma tarefa operacional de rotina, como um reinício controlado ou uma reposição para um ambiente de teste. Tudo o que não conseguir fazer é uma lacuna. Fazer isto anualmente para sistemas de nível 1 é equivalente a um teste de reposição e é igualmente algo que muitas vezes se ignora.
Posso personalizar este modelo de documentação da infraestrutura?
Sim, todas as versões são totalmente editáveis. Ajuste os níveis de criticidade e os campos ao seu ambiente. As duas coisas que vale a pena manter são a data de última verificação e o mapeamento de dependências em ambos os sentidos, porque são elas que determinam se a documentação é confiável e se ajuda durante um incidente.