Trupeer Blog
Samenvatten
Meer artikelen lossen een kapte interne kennisbank niet op. Ik heb gezien dat bedrijven honderden pagina's publiceren, nog een zoekvak toevoegen, en medewerkers toch dezelfde vragen in Slack laten stellen, omdat het kernprobleem niet de hoeveelheid content is. Het is cross-systeem discovery, bron-eigenaarschap en onderhoud.
Een bruikbare bedrijfswiki moet een sales engineer helpen de huidige sandbox-procedure te vinden, support helpen een goedgekeurd escalatiepad te volgen, en product marketing helpen bevestigen welke prijsrichtlijnen nog steeds geldig zijn. Dat betekent documentatie behandelen als een besturingssysteem voor organisatorische kennis, niet als een digitale archiefkast.
Korte samenvatting: Om een interne kennisbank te bouwen die medewerkers echt gebruiken, begin je met de veelvoorkomende vragen die mensen al in Slack stellen, organiseer je pagina's rond taken in plaats van afdelingen, geef je elk artikel een eigenaar en een review-by datum, volg je zoekresultaten en zoekopdrachten zonder resultaat, en gebruik je schermopnames plus AI om processen vast te leggen van de experts die ze uitvoeren.
Inhoudsopgave
Waarom de meeste interne kennisbanken falen
Een interne kennisbank faalt wanneer het verandert in een statisch documentkerkhof in plaats van een beheerde laag die mensen helpt informatie te ontdekken en te valideren in de tools die ze al gebruiken.
APQC-onderzoek zet de productiviteitskosten in concrete termen. Kenniswerkers besteden gemiddeld 8,2 uur per week aan het zoeken naar, opnieuw maken of dupliceren van informatie. Dat omvat 2,8 uur zoeken naar of aanvragen van informatie, 1,7 uur het identificeren van collega's met relevante expertise, 2,0 uur het opnieuw maken van werk dat al bestaat en 1,7 uur het herhalen van informatie of updates voor anderen, volgens APQC's onderzoek naar kennismanagementproductiviteit.
Het wordt nog interessanter wanneer je zoektoegang vergelijkt met zoekkwaliteit. APQC rapporteert dat medewerkers met enterprise search ongeveer 0,7 uur per week besteden aan het zoeken naar of aanvragen van informatie, zo'n 2,1 uur minder dan het gerapporteerde gemiddelde. Zoeken is belangrijk, maar alleen wanneer het leidt naar gezaghebbend materiaal en het antwoord herbruikbaar maakt.

Het repository is zelden het echte probleem
Ik heb gemerkt dat medewerkers vaak dagelijks tussen meerdere systemen schakelen om één eenvoudige vraag te beantwoorden. Een enquête uit 2025 onder medewerkers bij bedrijven met 5.000 of meer werknemers vond dat medewerkers ongeveer vier systemen per dag gebruiken om informatie te vinden, terwijl een kwart nog steeds niet weet waar ze antwoorden moeten zoeken. Frustratie over ontoereikende tools steeg van 28% in 2022 naar 40% in 2025, volgens het Coveo-rapport dat is behandeld door SiliconANGLE.
Een extra wiki of een generieke AI-chatbot lost die fragmentatie niet automatisch op. Als de nieuwe tool geen bronkaart, permissiemodel, freshness-signaal of escalatiepad heeft, kan het medewerkers dwingen te kiezen tussen nog meer tegenstrijdige antwoorden.
Een sales engineer zoekt mogelijk naar het nieuwste beleid voor prijsuitzonderingen in Slack, Notion en een intranet. De informatie bestaat, maar één document is verouderd, de Slack-thread heeft geen eigenaar en de intranetpagina gebruikt “commercial accommodation” in plaats van “pricing exception.” Een groot repository helpt niet tenzij het systeem de juiste bron identificeert en laat zien waarom het antwoord betrouwbaar is.
Praktische regel: Sla duurzame procedures op in een beheerde kennislaag, maar koppel die laag aan de systemen waar de huidige beslissingen, expertise en operationeel bewijs al leven.
De historische verschuiving is belangrijk. Kennismanagement is verschoven van statische opslag van documenten naar zoeken, governance, hergebruik en bron-bewuste retrieval. De IDC- en McKinsey-bevindingen die zijn samengevat in deze enterprise search ROI-analyse hielpen interne documentatie neerzetten als productiviteitsysteem in plaats van een optioneel communicatiekanaal.
Als je het aan mij vraagt, presteert een kleinere verzameling beheerde, doorzoekbare procedures die gekoppeld zijn aan operationele systemen beter dan een enorme bedrijfswiki met zwak eigenaarschap. Het doel is niet om alles te publiceren. Het doel is om het juiste antwoord vindbaar, actueel en veilig herbruikbaar te maken. Voor een praktische vergelijking tussen een repository en een werkend kennissysteem, is deze gids over wat een kennisbank is een nuttig startpunt.
Hoe verschillende teams bedrijfswiki's gebruiken
Een bedrijfswiki levert waarde op wanneer hij de terugkerende workflows vastlegt die elk team uitvoert, niet wanneer elke afdeling wordt gedwongen in hetzelfde documentatiesjabloon te passen.
In mijn werk hebben product marketing, sales engineering, customer success, learning and development en IT allemaal verschillende soorten interne kennis nodig. Product marketing heeft launch-assets en positioneringscontext nodig. Sales engineers hebben betrouwbare technische procedures nodig. Support heeft beslisbomen nodig die werken onder druk. L&D heeft gestructureerde leertrajecten nodig, terwijl IT gecontroleerde runbooks en change records nodig heeft.

Koppel het kennismodel aan de taak
Ik begin meestal met de vraag: “Wat moet deze persoon als volgende doen?” Dat levert betere documentatie op dan vragen welke afdeling de pagina beheert.
Product marketing heeft launch-checklists, competitieve battle cards, goedgekeurde messaging, wijzigingen in packaging en links naar bewijs achter claims nodig. Alleen een release note is niet genoeg als sales moet weten wat er is veranderd, welk publiek wordt geraakt en welke taal is goedgekeurd.
Sales engineering heeft instructies voor sandbox setup, integratievereisten, security-responses, architectuurdiagrammen en afhandeling van bezwaren nodig. Deze pagina's moeten afhankelijkheden vroeg zichtbaar maken. Een procedure die vereiste permissies weglaat, creëert meer interne vragen dan hij beantwoordt.
Customer success en support hebben troubleshooting-macro's, escalatiecriteria, notities over productgedrag en templates voor uitleg richting klanten nodig. Hun pagina's moeten standaardoplossingen onderscheiden van uitzonderlijke gevallen.
Learning and development heeft onboardingpaden, curricula op basis van rollen, oefenopdrachten en begeleiding bij assessments nodig. Een linkdump is geen leerervaring.
IT en operations heeft toegangsprocedures, incident runbooks, change-management workflows en details over eigenaarschap nodig. Deze documenten moeten de veilige actie duidelijk maken en de risicovolle actie moeilijk. Bekijk hoe je een doorzoekbare interne kennisbank voor IT service desk teams bouwt.
Elke kernprocedure moet vijf operationele vragen beantwoorden:
Wat triggert de workflow?
Welke inputs of permissies zijn vereist?
Welke exacte stappen moet de medewerker volgen?
Welke uitzonderingen vereisen escalatie?
Wie is eigenaar en beoordeelt de procedure?
Een supportmedewerker moest ooit een zending afhandelen waarvoor controles op visquarantaine en speciale verpakking nodig waren. Zonder gedocumenteerde operationele know-how had de medewerker een ervaren collega moeten vinden en het proces uit het hoofd moeten reproduceren. Met een interne wiki met de quarantaineprocedure en het verpakkingshandboek kon de medewerker de goedgekeurde workflow volgen en alleen uitzonderlijke gevallen escaleren. Chenfu rapporteerde een verbetering van 20% in niveaus van customer service en businessproductiviteit na het introduceren van een interne wiki voor dit soort know-how, zoals beschreven in dit verslag van de implementatie van kennisdeling.
Een bruikbaar artikel is geen samenvatting van wat een team weet. Het is een veilig pad door een taak die iemand anders moet afronden.
Hetzelfde principe geldt voor teams in professional services, waar herbruikbare expertise vaak in projectbestanden en individuele werkgewoonten zit. Een professional services kennisbank framework biedt nuttige context om firm knowledge om te zetten in herhaalbare assets.
Informatiearchitectuur ontwerpen voor vindbaarheid
Medewerkers zoeken op uitkomsten, niet op org charts. “Reset SSO,” “approve a refund,” en “create a sandbox account” beschrijven werk dat ze moeten afronden. “IT documentation,” “Finance policies,” en “Solutions Architecture” beschrijven eigenaarschap, maar wijzen zelden direct naar het antwoord.
Een wiki per afdeling organiseert kennis rond rapportagelijnen. Een doorzoekbare kennis hub organiseert het rond gebruikersintentie en verbindt vervolgens de relevante procedures over systemen heen. Een geteste vergelijking vond dat het reorganiseren van content rond taken het aantal taken dat binnen drie klikken wordt afgerond verhoogde van 4 van 12 naar alle 12, terwijl de mediane navigatieafstand daalde van 4,5 klikken naar 2,5. Labels verbeterden van het matchen van taaktaal in 4 van 12 gevallen naar alle 12, volgens deze informatie-architectuurvergelijking voor kennisbanken.
Gebruik taaktaal vóór eigenaarschapstaal
Department-Centric Title | Task-Centric Title | User Intent |
|---|---|---|
IT Access Management | Reset SSO Access | Restore access without opening an avoidable ticket |
Finance Policies | Approve a Customer Refund | Complete the approval workflow correctly |
Solutions Architecture | Create a Sandbox Account | Prepare a technical demo environment |
Product Operations | Publish a Release Note | Communicate a product change using the approved process |
Customer Support | Escalate a Billing Issue | Route an unusual case with the right evidence |
Bouw de architectuur in lagen. Het hoogste niveau moet de gebruikelijke taken weerspiegelen, zoals “Manage access,” “Support customers,” “Prepare a demo,” en “Launch a product.” Elke taakpagina moet prerequisites, gerelateerde procedures, templates, systeemlinks en escalatieroutes verbinden.
Een sales engineer die zoekt op “create a sandbox account” moet direct bij de procedure uitkomen, in plaats van een pagina van de IT-afdeling te openen en opnieuw te zoeken. De pagina kan IT nog steeds als eigenaar identificeren. Eigenaarschap hoort in metadata en governance, niet als de enige route naar het antwoord.
Valideer de structuur met gedrag
Keur een informatiearchitectuur alleen goed nadat je hem hebt getest met echte queries van nieuwe medewerkers, support agents, sales engineers en managers. Feedback tijdens workshops beloont vaak nette categorieën die niet overeenkomen met hoe medewerkers urgent werk beschrijven.
Noem pagina's met de woorden die medewerkers gebruiken, inclusief synoniemen en veelgebruikte afkortingen.
Groeperen van gerelateerde taken, terwijl je de primaire actie dicht bij de bovenkant houdt.
Koppel prerequisites en vervolgstappen, zodat gebruikers hun zoektocht niet opnieuw starten tussen systemen.
Volg klikdiepte en voltooiing, vooral voor workflows met veel verkeer.
Beoordeel mislukte queries, omdat terminologische gaten vaak in zoeklogs opduiken voordat iemand een probleem meldt. Gebruik querypatronen om labels, redirects en ontbrekende content te verbeteren voor een praktische handleiding bij het ontwerpen van een kennisbank-zoekervaring die werkt.
Structuur bepaalt ook of medewerkers informatie kunnen vinden over tools heen. Balans in hiërarchie, hubs en cross-links, en wijs elke pagina naar de gezaghebbende bron wanneer de echte workflow zich in een ticketing tool, CRM, identity platform of code repository bevindt.
Een bedrijfswiki verdient vertrouwen wanneer hetzelfde antwoord bereikbaar is via taaknavigatie, een keyword query of een contextuele link vanuit een andere procedure. Die routes moeten samenkomen op één onderhouden bron, in plaats van gekopieerde pagina's te creëren die uit elkaar gaan lopen. Als één discovery-route faalt, moeten de andere routes medewerkers nog steeds naar het actuele antwoord leiden.
Governance- en contentvervalbeleid
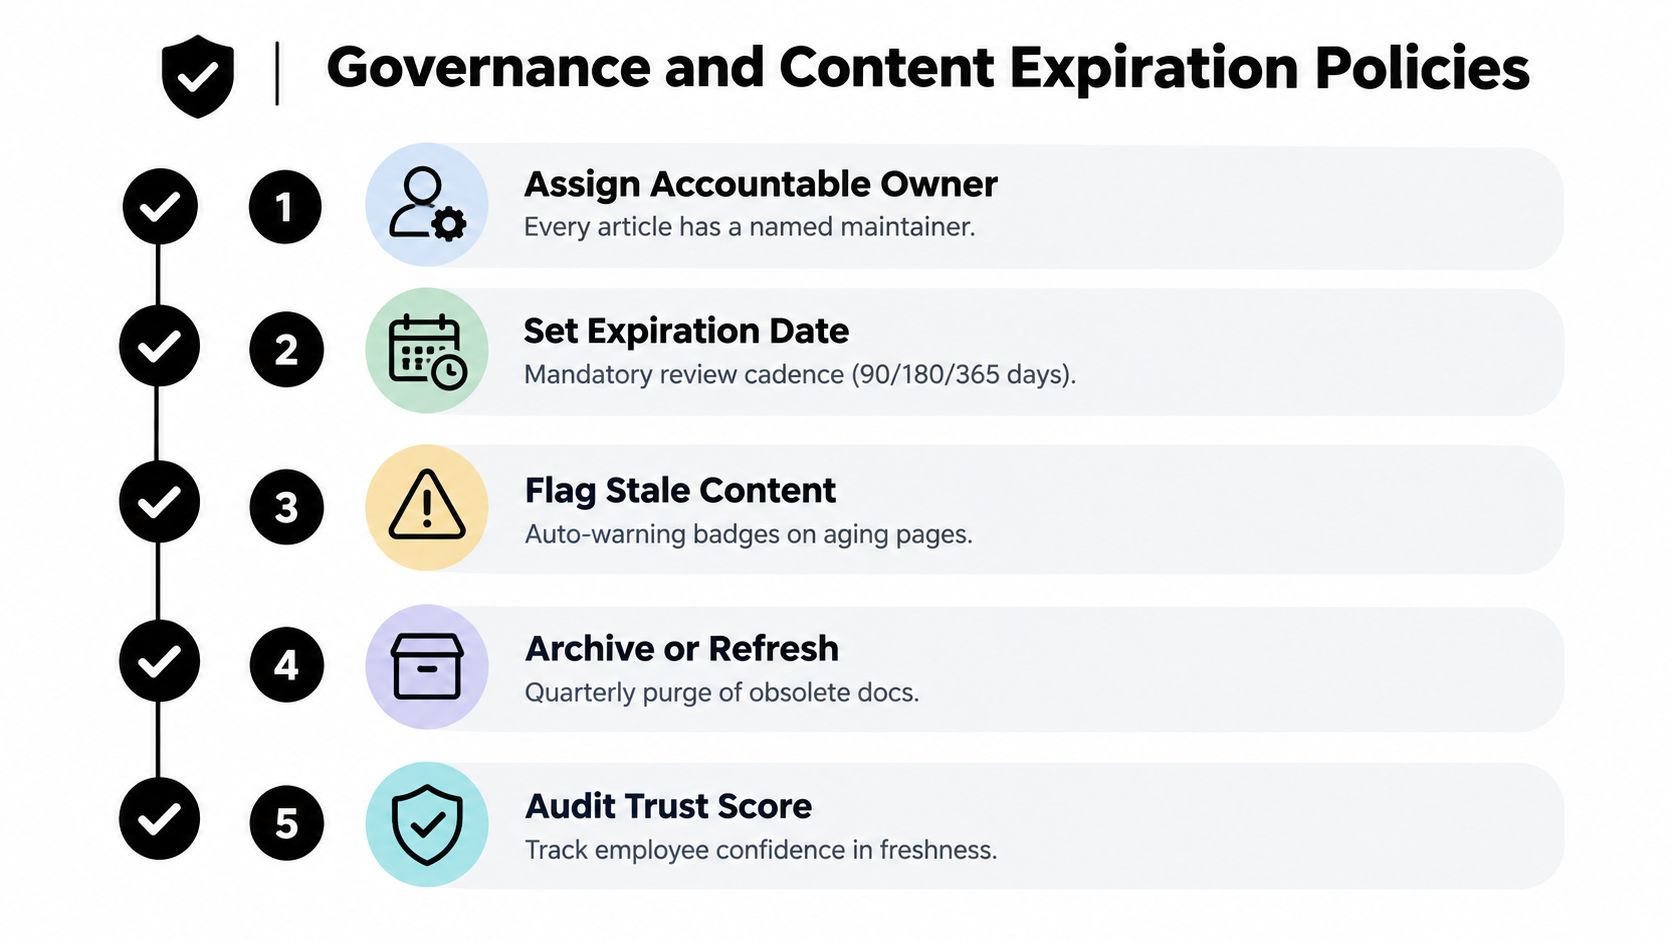
Een interne kennisbank heeft een levenscyclus nodig. Elk kritisch artikel moet een benoemde eigenaar hebben, een review-by datum, een evidence-veld en een duidelijke actie wanneer de content verloopt.
Ik heb gezien dat teams publicatievolume vieren terwijl ze onderhoud negeren. Dat creëert een gevaarlijke illusie van vooruitgang. Medewerkers openen een artikel, volgen een verouderde instructie, verliezen vertrouwen en keren terug naar privéberichten in Slack of persoonlijke notities. Zodra dat patroon ontstaat, wordt het zelfs moeilijker om accurate pagina's te ontdekken, omdat de organisatie weer is teruggeschakeld naar tribal knowledge. Een tribal knowledge audit helpt je vinden wat nog alleen in de hoofden van mensen leeft.
Maak eigenaarschap zichtbaar
Voor elk belangrijk artikel wijs ik toe:
Een verantwoordelijke eigenaar: Een persoon of rol die verantwoordelijk is voor nauwkeurigheid, niet alleen de afdeling die de pagina oorspronkelijk heeft geschreven.
Een review-by datum: Een zichtbare deadline gekoppeld aan het tempo waarmee het onderwerp verandert.
Een evidence-veld: De productbeslissing, policy, ticket, release record of bron die de richtlijn ondersteunt.
Een contentstatus: Draft, approved, under review, superseded of archived.
Een vervalactie: Vernieuw, vervang of verwijder het artikel wanneer de reviewdatum voorbij is.
Het ritme moet aansluiten op het risico. Een stabiele uitleg voor onboarding kan een ander reviewritme verdragen dan een prijsrichtlijn, toegangsprocedure of incident runbook. Het doel is niet om elke pagina door een identieke kalender te dwingen. Het doel is om te voorkomen dat belangrijke content onzichtbaar veroudert.
Koppel onderhoud aan operationele signalen
Een prijsrichtlijn kan actueel lijken tot wijzigingen in packaging. Een product marketing-eigenaar moet een review-trigger ontvangen wanneer een release de planstructuur wijzigt, niet maanden later wanneer een sales representative een tegenstrijdigheid opmerkt.
Ik geef de voorkeur aan een dashboard dat veelgebruikte pagina's markeert met reviews die te laat zijn, dubbele instructies, onbeantwoorde feedback en herhaalde vervolgvragen. Een artikel dat veel wordt gebruikt verdient meer aandacht dan een zelden bezochte historische notitie, zeker wanneer het onderwerp klanten, toegang, revenue operations of compliance beïnvloedt.
Governance-principe: Freshness is onderdeel van nauwkeurigheid. Een pagina zonder eigenaar of review-trigger is incompleet, zelfs als de tekst uitstekend is.
Versiebeheer is ook belangrijk. Teams moeten kunnen zien wat er is veranderd, waarom het is veranderd en welke eerdere instructie het vervangt. Een praktische SOP version-control workflow kan teams helpen procedurele wijzigingen controleerbaar te maken zonder elke update om te zetten in een bureaucratisch project. Voor guides en helpartikelen worden dezelfde principes behandeld in deze documentation version control-gids.
Zoekkwaliteit meten en succesmetrics
Zoekkwaliteit moet een operationele metric zijn, niet een vage wens voor gebruikerservaring. Ik kijk of medewerkers het juiste artikel vinden en aanklikken, of belangrijke queries niets opleveren, en of content met veel waarde binnen de reviewverplichting blijft.
Een governance-benchmark adviseert een zoek-succesrate tussen 70% en 85%, waarbij zoekopdrachten zonder resultaat onder 5% tot 10% blijven, en waarbij meer dan 80% van de topartikelen binnen de freshness service-level agreement van de organisatie wordt beoordeeld.
Zet zoekfouten om in een backlog
Zoekanalytics onthullen problemen die content-audits missen. Stel dat medewerkers herhaaldelijk “expense reimbursement” typen, maar het goedgekeurde artikel de titel “employee disbursement policy” heeft. De content bestaat, maar het kennissysteem faalt omdat de titel, synoniemen en metadata de taal van medewerkers niet koppelen aan de officiële terminologie.
Ik beoordeel maandelijks zoekgedrag en sorteer mislukkingen in categorieën:
Terminologie-gat: Het antwoord bestaat onder andere taal.
Dekkings-gat: Er bestaat geen betrouwbaar artikel.
Permissieprobleem: De juiste content bestaat, maar is niet zichtbaar voor de juiste rol.
Rangschikkingsprobleem: Een minder gezaghebbende pagina verschijnt als eerste.
Freshness-probleem: Het resultaat is technisch relevant, maar niet langer accuraat.
Elke categorie heeft een andere oplossing nodig. Een alias toevoegen lost een niet-gedocumenteerde workflow niet op. Een nieuw artikel publiceren lost een permissiefout niet op. Een titel herschrijven lost een verouderde procedure niet op.
Voor leadership koppel ik zoekmetrics aan operationele uitkomsten zonder te doen alsof één dashboardgetal alles verklaart. Zoek-succes geeft vindbaarheid aan. Zoekopdrachten zonder resultaat geven dekkings- en vocabulaire-gaten aan. Review-compliance geeft aan of medewerkers kunnen vertrouwen op wat ze vinden. Samen laten deze metingen zien of het interne documentatiesysteem betrouwbaar wordt.
Een bruikbaar metricsmodel voor IT- en operations-teams is beschikbaar in deze gids naar knowledge-base metrics die ROI aantonen aan leadership. De essentiële gewoonte is simpel: bekijk de data, wijs een eigenaar toe aan het grootste patroon van falen en controleer of de verandering het gedrag van de volgende maand verbeterde.
De juiste tooling en AI-workflows kiezen
De juiste tool voor interne kennisbanken vermindert de frictie tussen werk uitvoeren en documenteren hoe je het doet. Voor enterprise SaaS-teams evalueer ik security, permissies, zoeken, integraties, schrijfsnelheid en onderhoud samen. Een gepolijste editor kan niet compenseren voor zwakke toegangscontroles, en krachtige AI kan niet compenseren voor verouderd bronmateriaal.
Handmatige documentatie is meestal de bottleneck. De persoon die de workflow kent is druk bezig met het uitvoeren ervan, terwijl de persoon die is aangewezen om het te documenteren de context mist om elke uitzondering vast te leggen. Schermopname en AI-ondersteund schrijven kunnen dat gat dichten door een echte demonstratie om te zetten in een videowalkthrough, gestructureerde SOP, screenshots en doorzoekbare stappen.
Evalueer de capture-to-reuse workflow
Ik vraag toolingvendors en interne teams om het volledige pad te demonstreren, niet alleen de editor:
Capture: Kan een expert een proces opnemen terwijl hij natuurlijk spreekt?
Structuur: Kan het systeem die opname omzetten in koppen, stappen, screenshots en hoofdstukken?
Discovery: Kunnen medewerkers zoeken in artikeldetext en videotranscripten? Dit is hoe semantic search werkt in een video-kennisbank.
Toegang: Ondersteunt het platform SSO, SCIM, granular permissions en restricted workspaces?
Vertrouwen: Kunnen reviewers bronnen, versies, eigenaren en updates zien?
Deployment: Ondersteunt het enterprise securityverwachtingen zoals ISO 27001, SOC 2 en GDPR-compliance?
Hergebruik: Kan dezelfde bron een SOP, onboarding manual, customer education asset of productvideo worden?

In mijn werk begint de beste workflow bij de operationele expert, niet bij een specialist in documentatie. Een sales enablement leader kan het proces opnemen voor het aanmaken van een sandbox account, de gebruikelijke faalpunten uitleggen en een AI-documentatieplatform zoals Trupeer een eerste concept laten produceren. De leader controleert vervolgens permissies, terminologie en uitzonderingen in plaats van elke screenshot handmatig te formatteren.
Trupeer zet schermopnames om in productvideo's, geschreven documentatie en doorzoekbare stap-voor-stap guides met screenshots, annotaties, koppen en hoofdstukken. Het kan interne zichtbaarheid-controls en enterprise identityvereisten ondersteunen, zodat teams restricted procedures gescheiden kunnen houden van breed gedeeld materiaal. Voor teams die opties vergelijken, behandelt deze roundup van de best knowledge base software de bredere categorie.
AI moet capture en onderhoud versnellen, niet het bedrijfsbeleid herschrijven zonder toezicht. Ik wil een menselijke goedkeuringsstap voor materiële wijzigingen, zichtbare herkomst en een duidelijke manier om een artikel als superseded te markeren. Het hulpmiddel verdient vertrouwen wanneer het governance makkelijker maakt, niet wanneer het onzekerheid verbergt achter een zelfverzekerd antwoord.
Hoe Trupeer je helpt een interne kennisbank te bouwen
Trupeer is gebouwd rond de capture-to-reuse workflow hierboven, zodat experts één keer een proces kunnen documenteren en medewerkers het later kunnen vinden:
Capture vanuit de expert: Neem elk proces op met de Trupeer Chrome-extensie, of upload een bestaande opname.
Krijg de video en de guide samen: Trupeer zet één opname om in een gepolijste video met AI-voiceover en een stap-voor-stap guide met screenshots.
Publiceer naar een doorzoekbare kennisbank: Een ingebouwde knowledge base organiseert video's en guides zodat medewerkers ze op één plek kunnen doorzoeken, of je kunt guides insluiten in Notion, Zendesk of Intercom.
Beheer toegang: SAML SSO, SCIM provisioning, rolgebaseerde toegang en meerdere workspaces houden restricted procedures gescheiden.
Doorstaan securityreviews: Trupeer heeft ISO 27001- en SOC 2-certificeringen.
Houd content actueel: Document versiegeschiedenis laat je eerdere versies bekijken en herstellen, en vertalingen naar 65+ talen blijven gekoppeld aan dezelfde bron.
Veelgestelde vragen over interne kennisbanken
Wat is het verschil tussen een bedrijfswiki en een kennismanagementsysteem?
Ik behandel een bedrijfswiki als een plek om interne pagina's te maken en te bekijken. Een breder kennismanagementsysteem behandelt ook zoeken over bronnen, permissies, eigenaarschap, reviewcycli, analytics en hergebruik. Een workflow met schermopnames kan helpen om de SOP, video en doorzoekbare artikel te maken die het bredere systeem nodig heeft.
Hoe krijg ik medewerkers zover om documentatie te gebruiken in plaats van vragen te stellen in Slack?
Ik begin met de vragen die medewerkers al in Slack stellen en publiceer taakgerichte antwoorden met hun taal. Korte walkthroughs die zijn gemaakt op basis van echte schermopnames kunnen de documentatie makkelijker te consumeren maken, terwijl links vanuit tickets, onboarding-checklists en support workflows het antwoord in het bestaande werk van de medewerker brengen.
Hoe moet ik omgaan met gevoelige informatie in een gedeeld repository?
Ik scheid publieke-to-the-company richtlijnen van restricted procedures en wijs toegang toe op basis van rol, workspace of team. Ik vereis ook een eigenaar en reviewdatum voor gevoelige pagina's, en test vervolgens retrieval met representatieve gebruikerspermissies zodat het systeem informatie niet blootstelt aan het verkeerde publiek.
Kan AI interne documentatie automatisch up-to-date houden?
Ik gebruik AI om waarschijnlijke wijzigingen te identificeren, conceptrevisies te maken, stappen uit opnames te extraheren en conflicterende bronnen te markeren. Ik vereis nog steeds dat een mens beleid- en proceswijzigingen goedkeurt, omdat een geautomatiseerde herschrijving nooit het officiële antwoord van het bedrijf mag worden zonder dat iemand het opmerkt.
Hoe snel kan ik een minimum viable kennisbank live zetten?
Ik ga live met een beperkte set aan veelvoorkomende workflows in plaats van te proberen het hele bedrijf te documenteren. Begin met de vragen die herhaaldelijk tickets opleveren, onboardingvertragingen veroorzaken of vermijdbare escalaties veroorzaken, en voeg vervolgens eigenaren, zoekanalytics en reviewdatums toe voordat je de verzameling uitbreidt.
Bouw een interne kennisbank die je teams echt gebruiken met Trupeer. Leg echte processen één keer vast als schermopnames en Trupeer zet ze om in video's, stap-voor-stap guides en SOP's in een doorzoekbare, toegangsgecontroleerde kennisbank. Probeer Trupeer gratis.