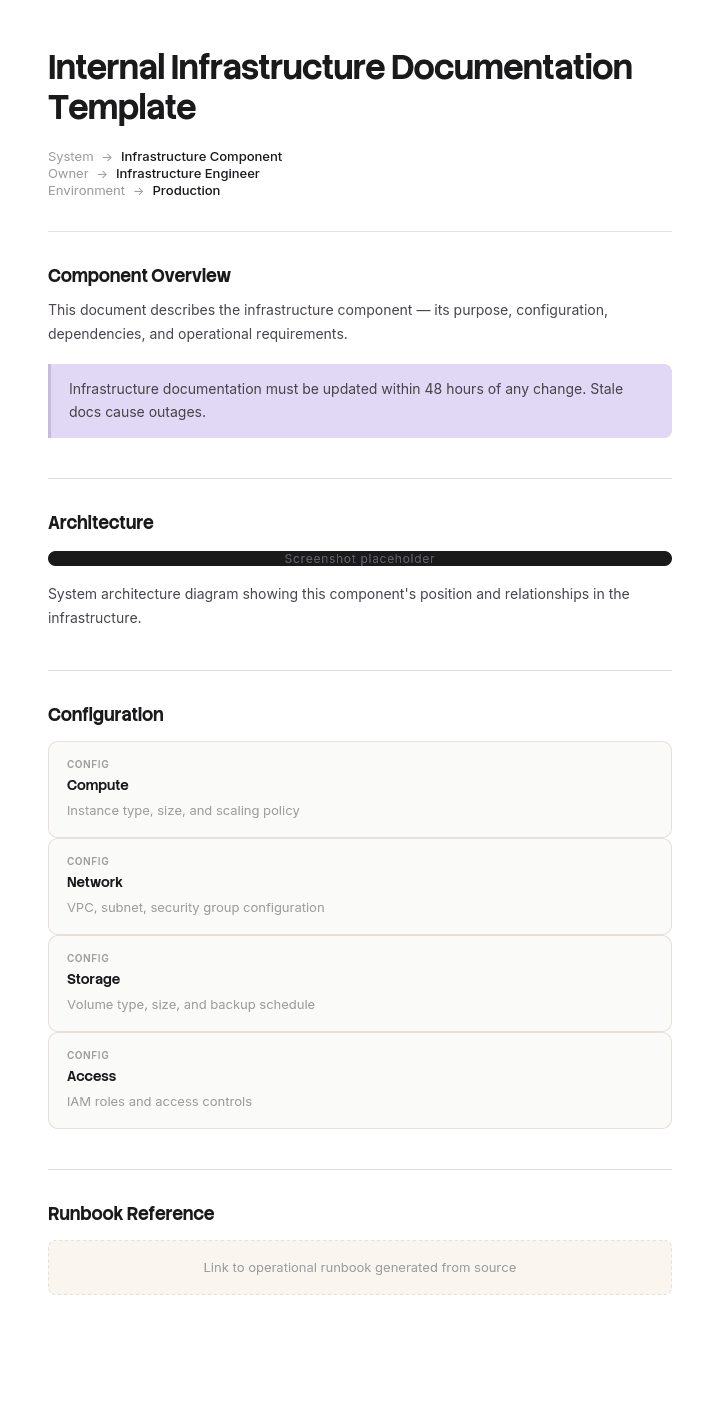
Verwenden Sie diese Vorlage
Starke interne Infrastruktur-Dokumentation schützt Ihr Unternehmen vor Ausfällen, Audits und Sicherheitsvorfällen. Mit Trupeer können Sie Stunden bei der Infrastruktur-Dokumentation sparen, indem Sie mit einer kostenlosen Vorlage starten, sie mit Ihren Brand Guidelines anpassen und die Dokumentation in Video-Durchläufe für IT-Teams und MSPs umwandeln.
Die meisten Infrastruktur-Dokumentationen werden einmal während eines Projekts geschrieben und sind innerhalb von sechs Monaten falsch. Sie bleibt im Wiki, niemand vertraut ihr, und während des nächsten Vorfalls liest sie jemand, zögert, und ruft die Person an, die es tatsächlich weiß.
Die Lösung ist nicht mehr Dokumentation. Es ist weniger Dokumentation, die wahr bleibt – ausgewählt, indem man fragt, was jemand tatsächlich um drei Uhr morgens brauchen würde.
Laden Sie die Vorlage für Infrastruktur-Dokumentation herunter
Format | Am besten für |
|---|---|
Excel (.xlsx) | Das Inventar, die Dependency-Matrix, Netzwerkinformationen und der Review-Tracker |
Word (.docx) | Runbooks, Architektur-Überblick und der DR-Plan |
Genehmigte Versionen und alles, was Auditoren anfordern | |
Google Sheets | Ein geteiltes Inventar, das das Team pflegt |
Google Docs | Runbooks, die während und nach Vorfällen bearbeitet werden |
Kostenlos, editierbar, ohne Wasserzeichen. Excel erledigt hier den Großteil der Arbeit, weil Infrastruktur-Dokumentation größtenteils strukturierte Daten sind, die so tun, als wären sie Prosa.
Welche Dokumentation brauchen Sie?
Sie müssen dokumentieren | Verwenden |
|---|---|
Welche Infrastruktur existiert und wie sie verbunden ist | Diese Vorlage |
IT-Prozesse, Richtlinien und allgemeine How-tos | |
Ein konkretes Projekt | |
Ein Softwareprodukt für seine Nutzer | |
Ein IT-Verfahren | |
Softwarearchitektur und -design |
So passen Sie diese Vorlage in Trupeer an
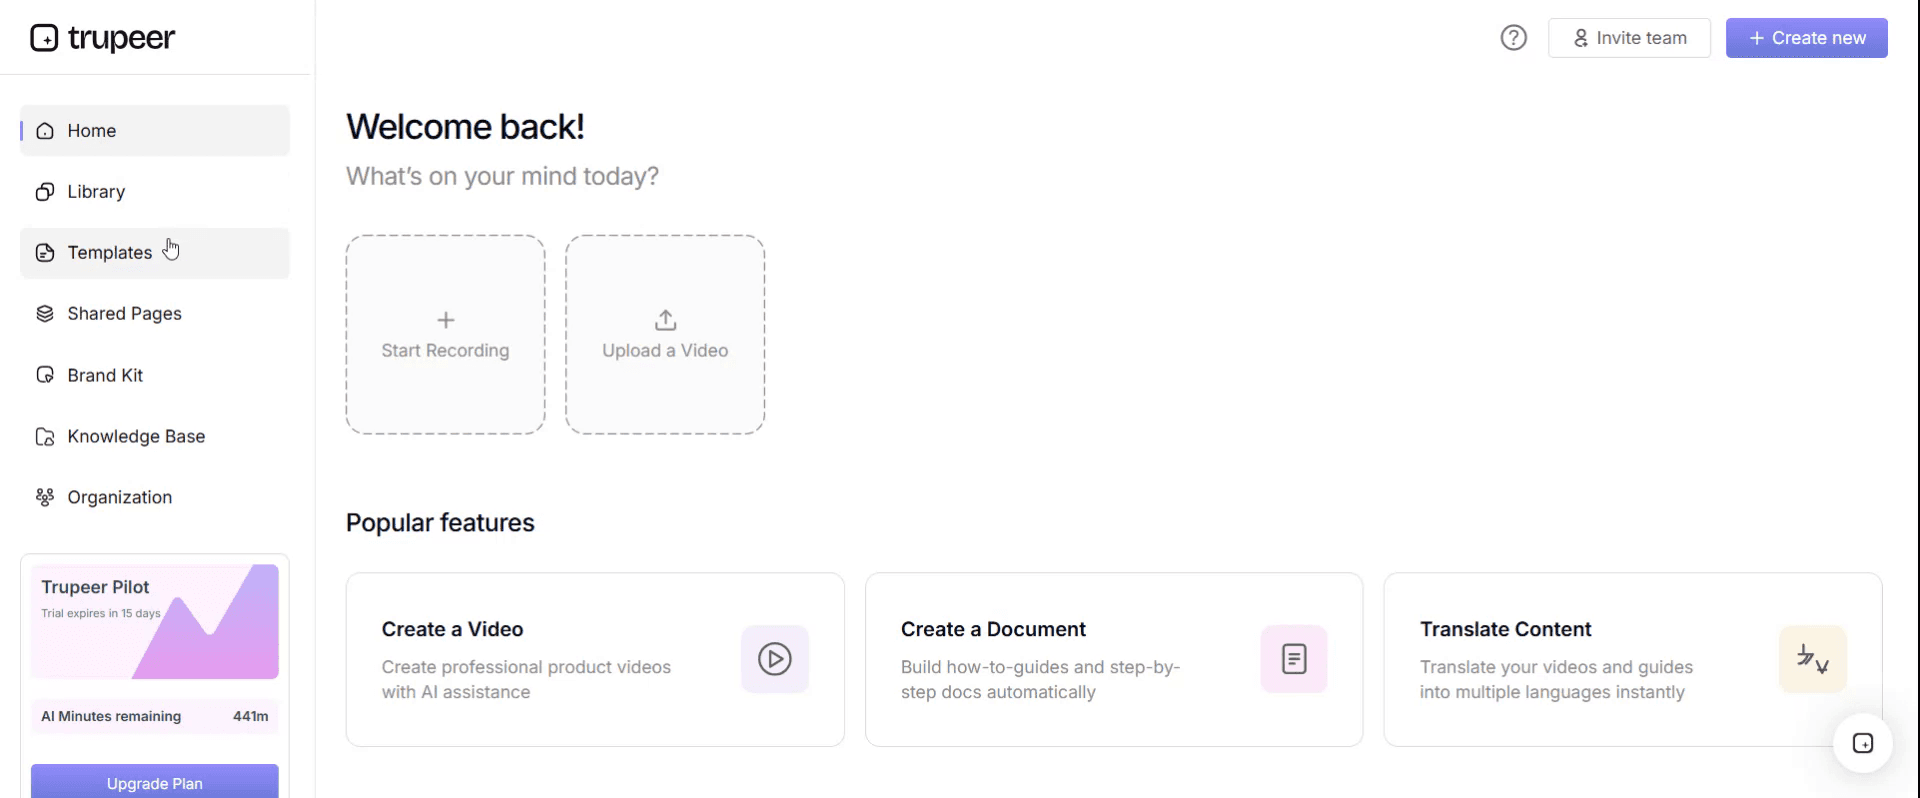
Schritt 1: Öffnen Sie den Bereich „Vorlagen“
Gehen Sie im Hauptmenü zum Bereich „Vorlagen“.
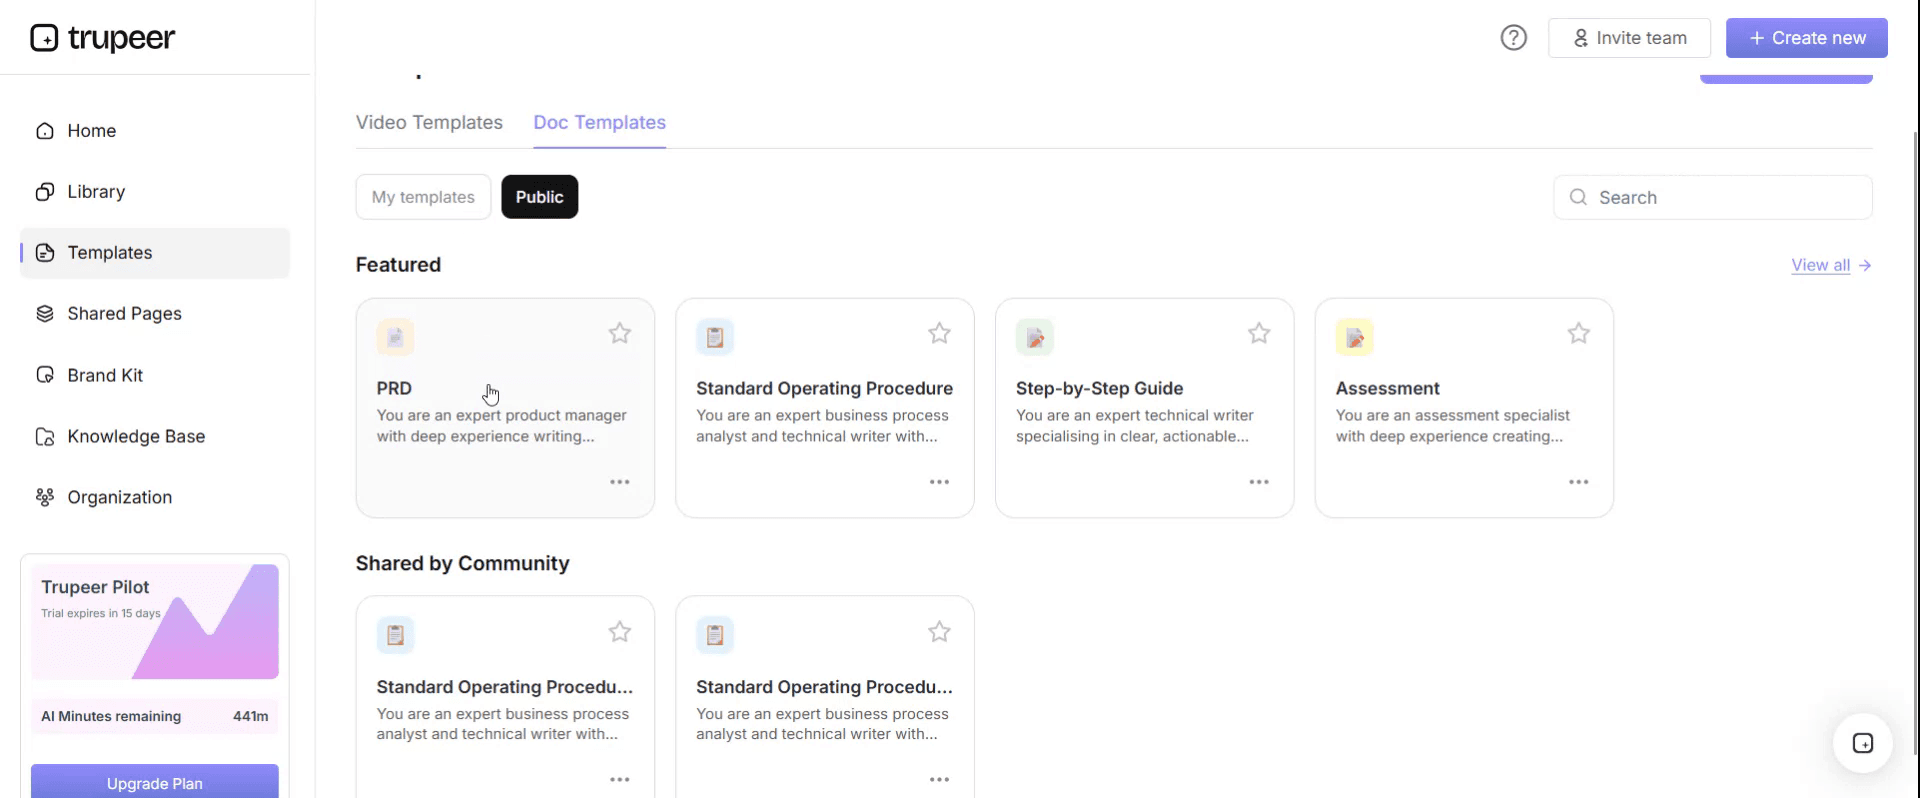
Schritt 2: Wählen und öffnen Sie eine Vorlage
Klicken Sie auf eine beliebige Vorlage, mit der Sie arbeiten möchten, um sie zu öffnen.
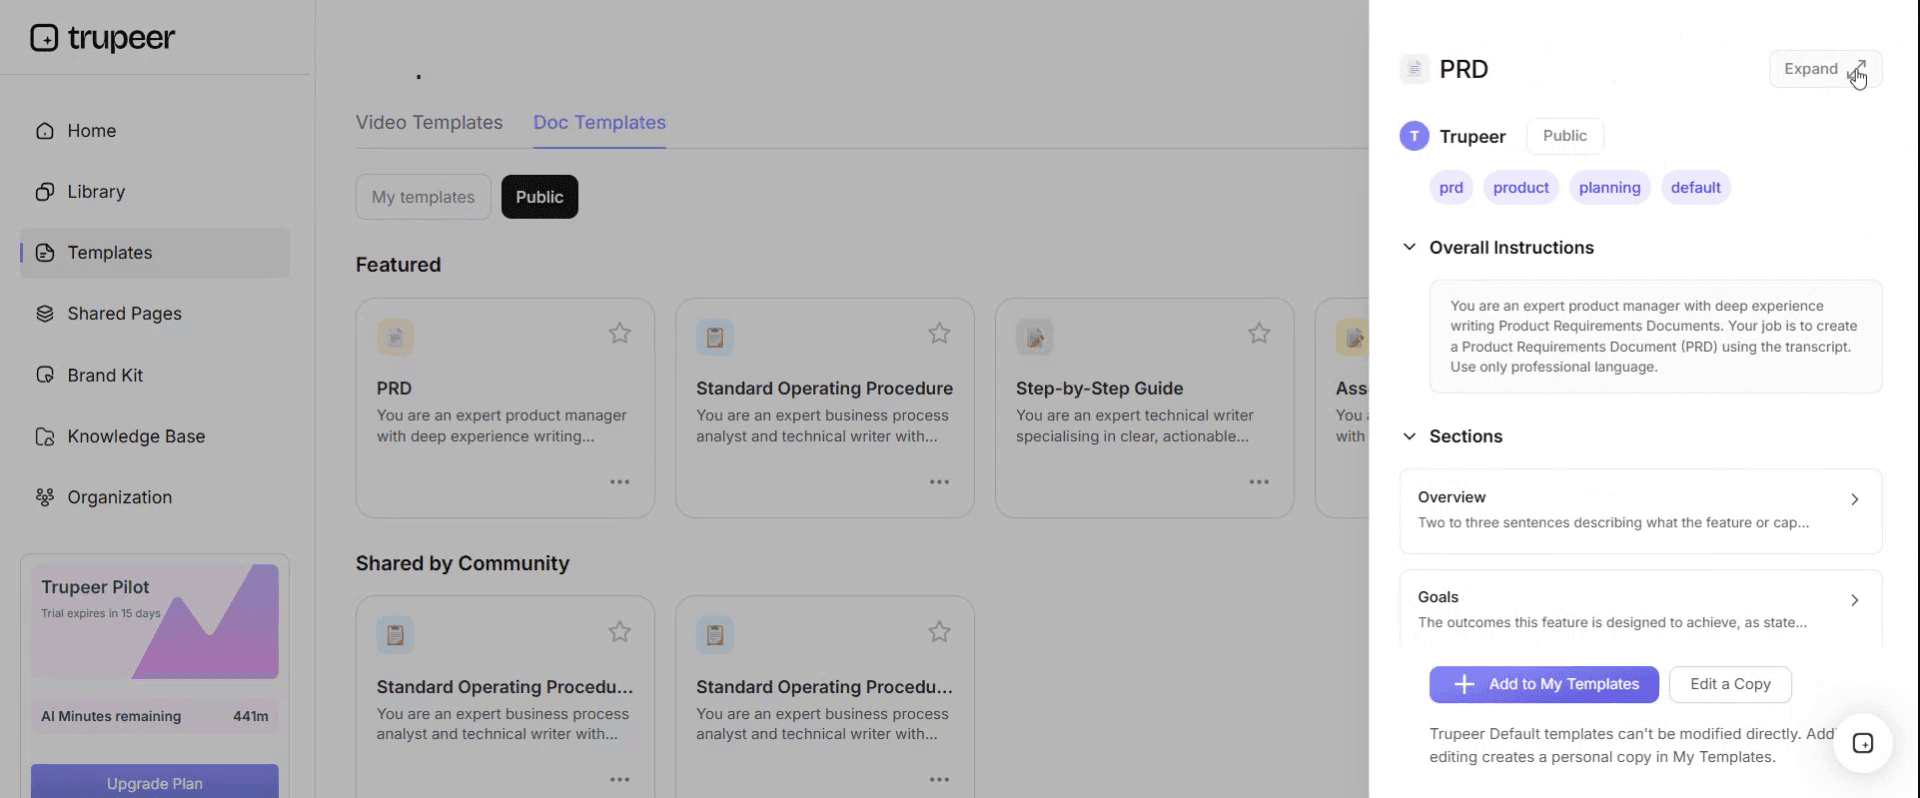
Schritt 3: Ansicht der Vorlage erweitern
Falls nötig, erweitern Sie die Vorlagenansicht, um das vollständige Layout und die Details klar zu sehen.
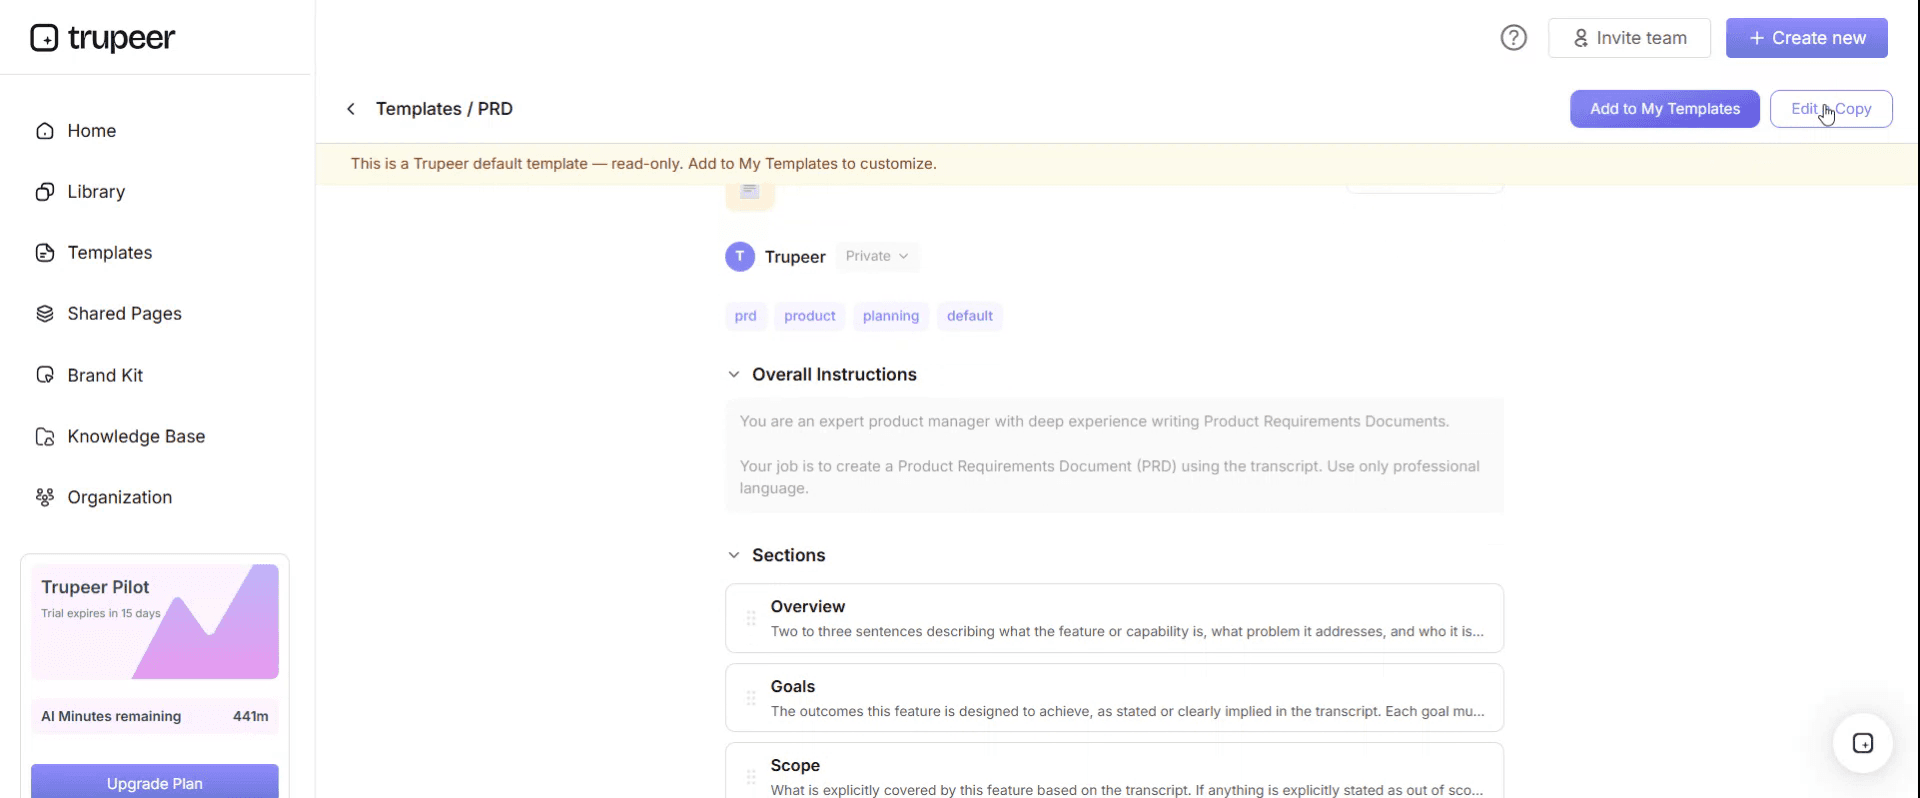
Schritt 4: Vorlage bearbeiten
Klicken Sie auf „Bearbeiten“, um mit der Modifikation der ausgewählten Vorlage zu beginnen.
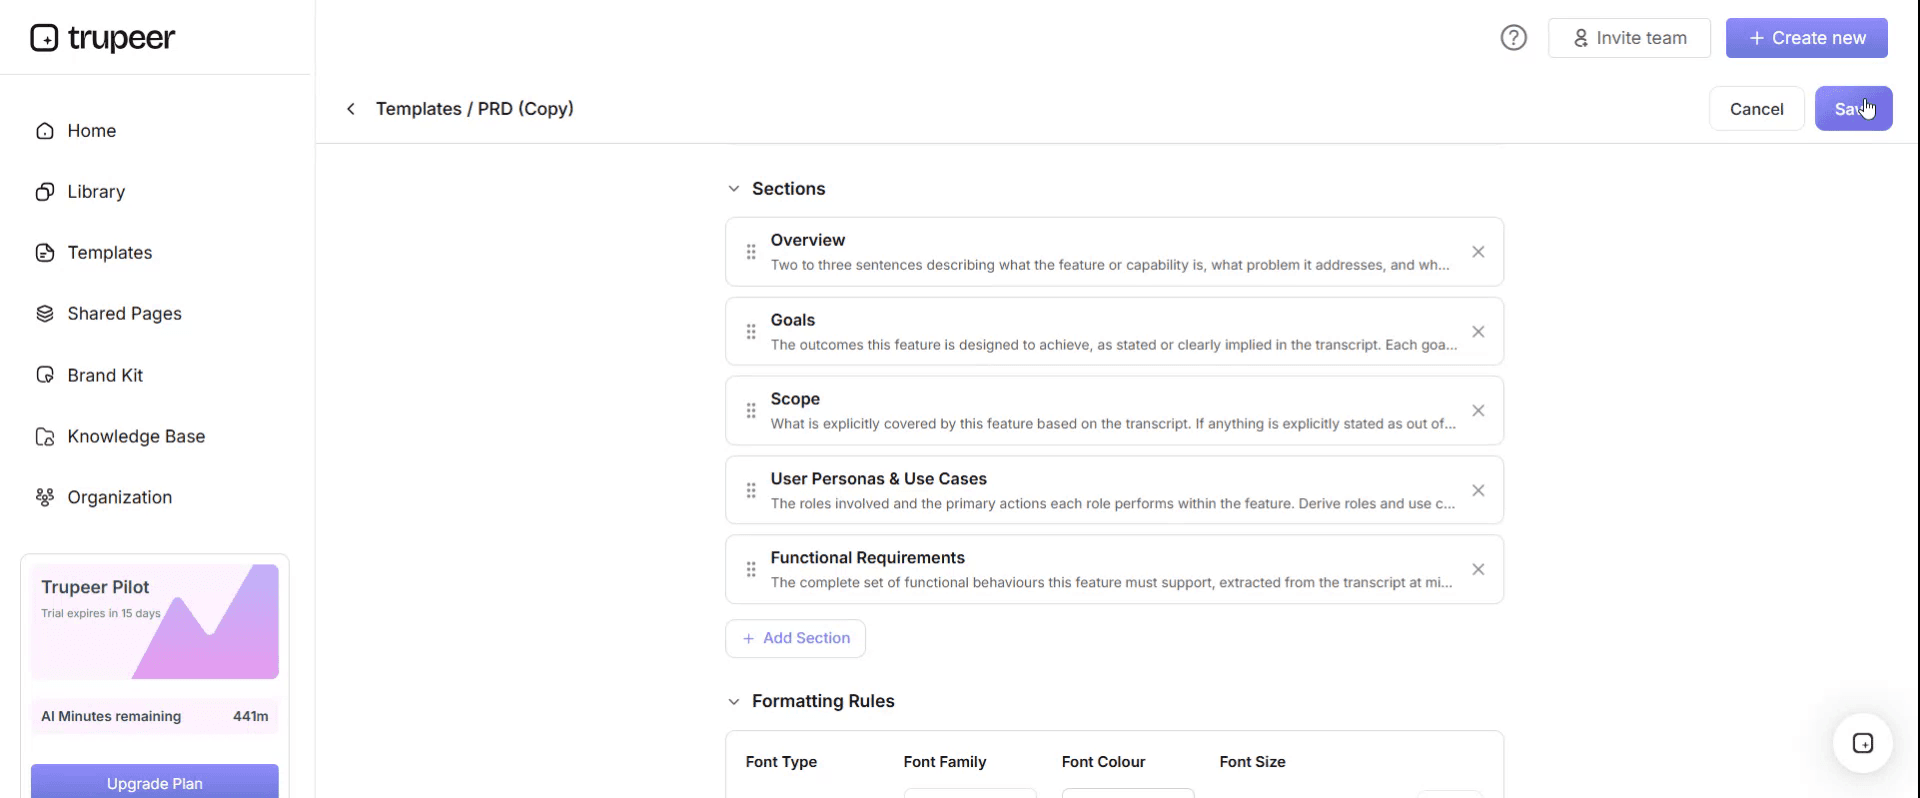
Im Editor können Sie:
Neue Abschnitte hinzufügen
Formatierungsregeln definieren oder aktualisieren
Ein Logo hinzufügen und Position sowie zugehörige Einstellungen anpassen
Schritt 5: Speichern Sie Ihre angepasste Vorlage
Klicken Sie nach allen notwendigen Änderungen auf „Speichern“, um die aktualisierte Vorlage als Ihre eigene zu sichern.
Schritt 6: Vorschau ansehen und Vorlage feinjustieren
Wenn Sie sehen möchten, wie Ihre angepasste Vorlage aussieht, öffnen Sie die Vorschau.
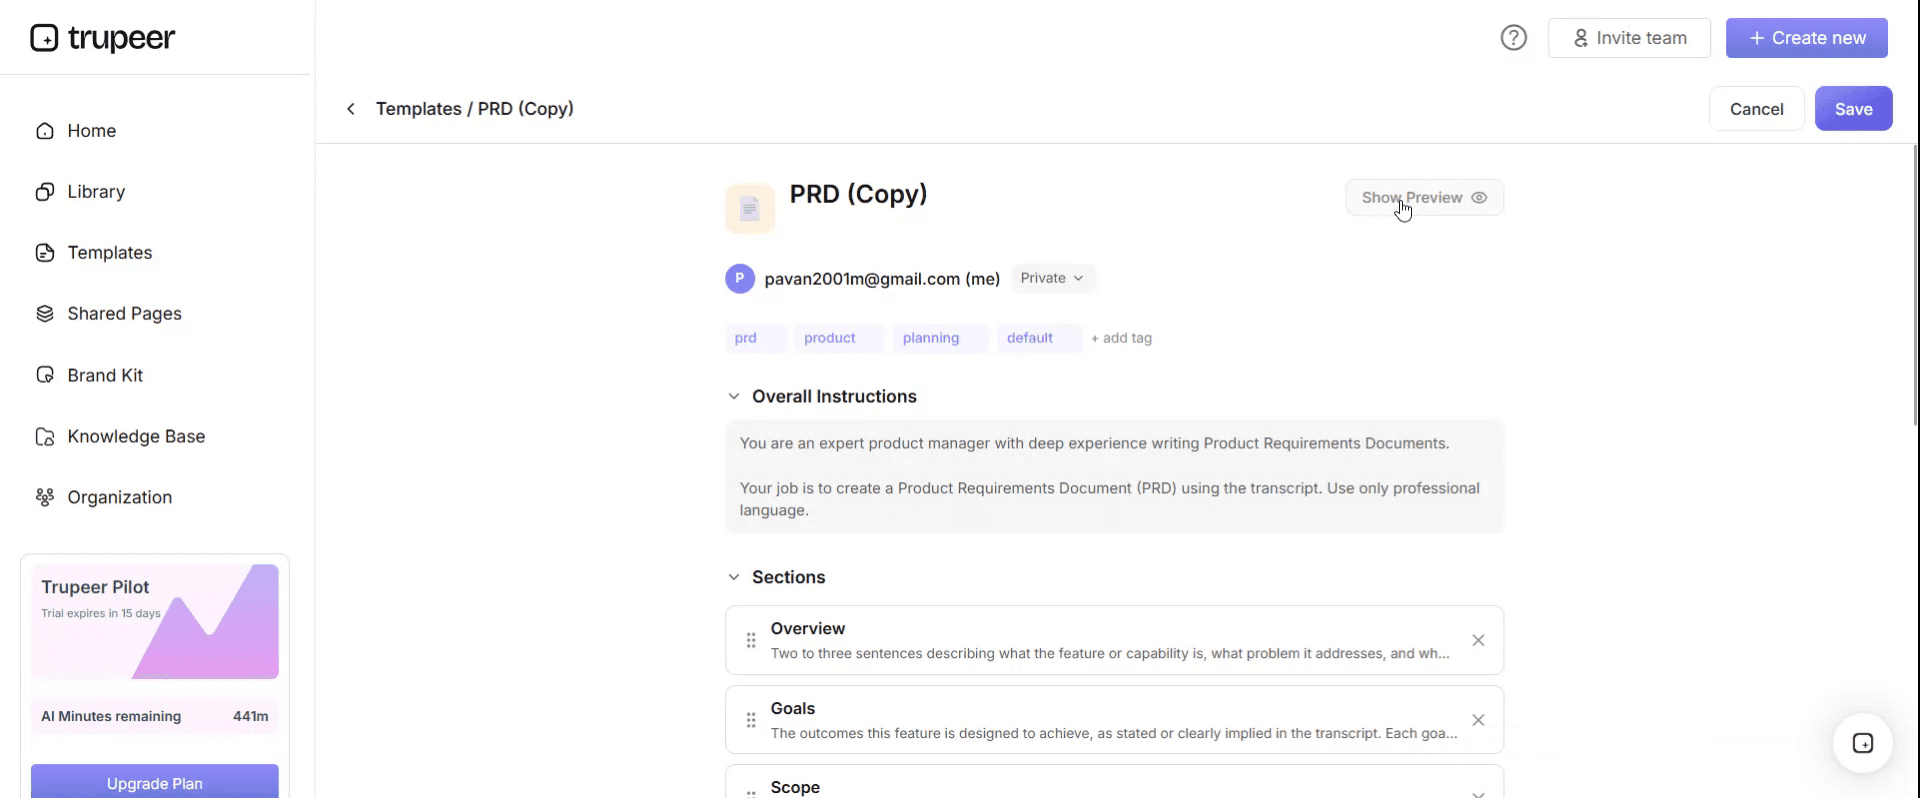
Ausgehend vom Vorschau-Bildschirm können Sie bei Bedarf weiterhin direkt Anpassungen vornehmen, damit die Vorlage genau so erscheint, wie Sie es möchten.
Mit einer internen Vorlage für Infrastruktur-Dokumentation können Sie:
Stunden beim Schreiben sparen: Überspringen Sie die leere Seite mit einer Struktur, die für IT-Infrastruktur gebaut ist.
Die Sicherheitslage verbessern: Integrierte Felder erzwingen sichere Praktiken im Umgang mit Zugangsdaten.
Markenkonform bleiben: Nutzen Sie Ihr Logo, Ihre Schriftarten und Farben aus dem Brand Kit von Trupeer.
Ausfallzeiten reduzieren: Klare Dokumentation senkt die MTTR während Vorfällen.
Audit-ready bleiben: Ausgerichtet auf SOC 2, ISO 27001 und ähnliche Frameworks.
Globale Teams erreichen: Übersetzen Sie die Dokumentation mit einem Klick in 65+ Sprachen.
Der 3-Uhr-Test
Der einzige Test, der für Infrastruktur-Dokumentation wirklich zählt.
Stellen Sie sich einen Vorfall um drei Uhr morgens vor. Die Person, die das System gebaut hat, ist im Flugzeug. Jemand ist kompetent, aber mit Ihrer Dokumentation nicht vertraut. Kann diese Person herausfinden, was kaputt ist, worauf es angewiesen ist, was passiert, wenn sie es neu startet, und wen sie eskalieren muss?
Alles, was dabei hilft, ist es wert, geschrieben zu werden. Alles andere ist optional – und optionale Dokumentation verwässert die nützlichen Teile und verbraucht das Wartungsbudget.
Wenden Sie es kompromisslos an. Eine detaillierte Historie, warum eine Technologie 2021 ausgewählt wurde, besteht nicht. Eine Notiz, dass dieser Dienst nach der Datenbank und vor dem API-Gateway gestartet werden muss.
Was den 3-Uhr-Test besteht
Was existiert. Systeme, Server, Services – mit jeweils einem Satz, was jeder einzelne macht.
Wo es sich befindet. Cloud-Provider und Region oder physischer Standort und Rack.
Woran es hängt – und worauf es sich stützt. Das wertvollste Element in der Infrastruktur-Dokumentation.
Wie man es erreicht. Hostnames, Adressen, Konsolen – aber niemals Zugangsdaten.
Wie „normal“ aussieht. So kann eine unbekannte Person erkennen, ob wirklich etwas falsch ist.
Was es kaputtmacht. Bekannte Ausfallmodi und ihre Symptome.
Wie man es sicher neu startet, einschließlich Reihenfolge und allem, was zuerst erledigt werden muss.
Wer dafür verantwortlich ist, und der Eskalationspfad mit echten Kontaktdaten.
Wie groß die Auswirkungen sind. Was alles ausfällt, wenn das hier ausfällt.
Was normalerweise nicht besteht
Für Vollständigkeit statt Nutzung geschrieben – und daher nicht wert, gepflegt zu werden.
Komplette Konfigurations-Dumps, die am Tag nach dem Export schon veraltet sind. Detaillierte Begründungen für frühere Entscheidungen, die in einem Architecture Decision Record statt in der operativen Dokumentation gehören. Jeder Parameter jedes Systems, wenn operativ nur ein paar wenige wirklich relevant sind. Screenshots von Konsolen, die schnell altern und selten helfen. Und alles, was anderswo eine Quelle der Wahrheit dupliziert – denn zwei Kopien bedeuten: eine ist falsch, und Sie können nicht erkennen, welche.
Grundsatz: Wenn es sich schneller aus dem System herausfinden lässt, als aus einem Dokument zu lesen, dann dokumentieren Sie es nicht.
Das Infrastruktur-Inventar
Das Fundament. Eine Zeile pro System oder Service.
Feld | Eintragen |
|---|---|
Name | So, wie er in Monitoring und im Gespräch erscheint |
Zweck | Ein Satz, in einfacher Sprache |
Typ | Server, Service, Datenbank, Netzwerkgerät, SaaS |
Umgebung | Produktion, Staging, Entwicklung |
Standort | Cloud-Provider und Region oder Standort und Rack |
Owner | Team und ein namentlich benannter Eskalationskontakt |
Kritikalität | Tier 1 bis 3, definiert unten |
Abhängig von | Was es braucht, um zu funktionieren |
Wird abhängig von | Was ausfällt, wenn es stoppt |
Zugriffsmethode | Konsole, SSH-Bastion, VPN. Keine Zugangsdaten |
Monitoring | Wohin die Alerts gehen |
Backup | Häufigkeit, Standort, zuletzt erfolgreich verifizierter Restore |
Runbook | Link |
Zuletzt verifiziert | Datum, an dem jemand bestätigt hat, dass diese Zeile wahr ist |
Das letzte Feld ist das, was die meisten Inventare auslassen – und das, was bestimmt, ob jemand dem Dokument vertraut. Eine Zeile, die niemand in zwei Jahren geprüft hat, sollte sichtbar als unzuverlässig gelten, statt still falsch zu sein.
Kritikalitäts-Tiers
Definieren Sie sie, denn sie bestimmen, wie viel Dokumentation jedes System verdient.
Tier | Bedeutet | Erwartete Dokumentation |
|---|---|---|
1 | Ein Ausfall stoppt das Geschäft | Vollständiges Runbook, getesteter DR, Dependency-Map, vierteljährlich geprüft |
2 | Ein Ausfall beeinträchtigt eine Funktion | Runbook, Abhängigkeiten, zweimal jährlich geprüft |
3 | Ein Ausfall ist für einen Tag tolerierbar | Nur Inventareintrag und Owner |
Die meisten Organisationen dokumentieren Tier 3 mit derselben Tiefe wie Tier 1, gehen dabei die Energie aus und enden damit, dass alles nur halb dokumentiert ist. Dokumentieren Sie Tier 1 richtig und lassen Sie Tier 3 bei einer einzelnen Zeile.
Abhängigkeiten
Der wertvollste und am häufigsten vernachlässigte Teil der Infrastruktur-Dokumentation.
Während eines Vorfalls lautet die Frage selten, was kaputt ist. Es geht darum, was sonst betroffen ist – und was dieses Ding braucht, um wieder zurückzukommen. Beides lässt sich nicht aus einer Serverliste ableiten.
Dokumentieren Sie Abhängigkeiten in beide Richtungen:
System | Abhängig von | Wird abhängig von | Startreihenfolge | Fällt aus, wenn Abhängigkeit ausfällt |
|---|---|---|---|---|
Order API | Postgres Primary, Redis, Auth-Service | Web-App, Mobile App, Partner-Integrationen | Nach Postgres und Auth | Ja, sofort |
Reporting-Service | Postgres-Replica | Nur interne Dashboards | Beliebig | Beeinträchtigt, liefert gecachte Daten |
Zwei Dinge machen das nützlich. Die Startreihenfolge, denn Dinge in der falschen Reihenfolge neu zu starten, macht aus einem kurzen Vorfall einen langen. Und ob die Abhängigkeit hart oder weich ist – denn ein Service, der sich gracefully verhält, ist ein ganz anderes Problem als einer, der sofort ausfällt.
Fügen Sie externe Abhängigkeiten hinzu. Zahlungsanbieter, Identitätsanbieter, DNS, Zertifizierungsstellen und SaaS-APIs verursachen Ausfälle, die Sie nicht selbst beheben können – und zu wissen, dass das schnell der Fall ist, ist um 3 Uhr morgens viel wert.
Netzwerk-Dokumentation
Element | Dokumentieren |
|---|---|
Netzwerksegmente | Zweck, Adressbereich, VLAN |
Routing | Zwischen Segmenten und ins Internet |
Firewalls | Wo sie sitzen, wer Regeln verwaltet, wie man eine Änderung anfordert |
VPN | Endpunkte, wer Zugriff hat, wie man es anfordert |
DNS | Zonen, wo sie gehostet sind, wer sie ändern kann |
Load Balancer | Was hinter jedem steckt, Health-Check-Verhalten |
Zertifikate | Wofür sie gelten, Ablauf, Owner der Erneuerung und Methode |
Externe Konnektivität | ISPs, Leitungen, Kontakte, Vertragsreferenzen |
Der Ablauf von Zertifikaten verdient besondere Aufmerksamkeit. Er verursacht Ausfälle, die vollständig vorhersehbar, vollständig vermeidbar und unverhältnismäßig wahrscheinlich sind, an einem Wochenende zu passieren. Dokumentieren Sie, was wann abläuft, wer es erneuert und ob die Erneuerung automatisiert ist.
Runbooks
Das Dokument, das jemand während eines Vorfalls tatsächlich öffnet.
Abschnitt | Inhalte |
|---|---|
System und Owner | Mit Eskalationskontakt |
Was dieses System macht | Ein Absatz |
Wie „normal“ aussieht | Metriken, erwartetes Verhalten, typischer Load |
Häufige Alerts | Was jeder bedeutet und was zu tun ist |
So starten Sie es sicher neu | Schritte, Reihenfolge, Voraussetzungen |
Bekannte Ausfallmodi | Symptom, Ursache, Lösung |
Was nicht zu tun ist | Die Aktionen, die die Situation verschlimmern |
Eskalation | Wann und an wen |
Zugehörige Runbooks | Abhängigkeiten |
Der Abschnitt „Was nicht zu tun ist“ ist selten und wertvoll. Jedes reife System hat eine Aktion, die vernünftig wirkt und den Vorfall verschlimmert: in der falschen Reihenfolge neu starten, einen Cache löschen, der sechs Stunden zum Wiederaufbau braucht, oder failover durchführen, wenn das Secondary hinterherhinkt.
Schreiben Sie Runbooks für Tier-1-Systeme und für alles, was bereits einen Vorfall verursacht hat. Nicht für alles.
Zugriff und Zugangsdaten
Der Abschnitt, in dem Dokumentation eher Schaden anrichtet als verhindert.
Geben Sie niemals Zugangsdaten in die Dokumentation. Keine Passwörter, keine API-Keys, keine Verbindungsstrings mit eingebetteten Secrets, keine privaten Keys. Nicht im Wiki, nicht in der Excel-Datei, nicht „vorübergehend“.
Dokumentieren Sie stattdessen die Zugriffsmethode. Welches System die Zugangsdaten hält, wer Zugriff gewähren kann und wie jemand sie um 3 Uhr morgens anfordert. Das ist das, was die Person tatsächlich braucht – und es ist sicher, es aufzuschreiben.
Stattdessen | Dokumentieren |
|---|---|
Das Admin-Passwort | Zugangsdaten in [vault], zugänglich für das Platform-Team, Break-Glass-Verfahren in [runbook] |
Ein API-Key | Key gespeichert in [secrets manager] als [name], quartalsweise rotiert durch [owner] |
Ein geteilter Login | Zugriff über SSO-Gruppe [name], Anfrage über [process] |
Dokumentieren Sie dann das Break-Glass-Verfahren korrekt, denn Notfallzugriff, der während eines Notfalls nicht verfügbar ist, ist ein häufiger und vermeidbarer Ausfall.
Disaster Recovery
Was die DR-Dokumentation enthalten muss, damit sie überhaupt etwas wert ist.
Recovery Time- und Recovery Point-Ziele pro Tier-1-System, mit dem Business abgestimmt statt von IT angenommen. Was das Recovery-Verfahren tatsächlich ist, Schritt für Schritt. Wo sich Backups befinden – und entscheidend: wann ein Restore zuletzt erfolgreich getestet wurde. Wer einen Disasterfall ausruft und wer den Plan aktiviert. Wie das Team kommuniziert, wenn normale Systeme nicht verfügbar sind, denn ein DR-Plan, der nur auf den Systemen gespeichert ist, die gerade nicht verfügbar sind, ist eine bekannte, peinliche Situation.
Die wichtigste Zeile in jedem DR-Dokument ist das Datum des letzten erfolgreichen Restore-Tests. Ein Backup, das nie wiederhergestellt wurde, ist eine Hypothese.
Diagramme
Von Diagrammen profitiert die Infrastruktur mehr als von den meisten anderen Dokumentationen – und sie werden schneller veraltet.
Ein High-Level-Diagramm mit den wichtigsten Komponenten und wie sie verbunden sind. Das ist das, was die Leute tatsächlich verwenden.
Netzwerk-Topologie, wenn die Umgebung komplex genug ist, dass man sie dafür braucht.
Datenfluss, insbesondere dort, wo er Trust-Grenzen oder Zuständigkeiten überschreitet.
Halten Sie sie einfach. Ein Diagramm, das niemand während eines Vorfalls auf einen Blick lesen kann, ist Deko.
Datieren Sie sie, und setzen Sie den Owner darauf.
Bevorzugen Sie Diagramme-as-code, wenn Ihr Team sie pflegt, denn ein Diagramm in einem versionkontrollierten Textformat wird mit der Änderung aktualisiert – nicht erst danach.
Ein falsches Diagramm ist schlimmer als gar kein Diagramm, weil Menschen Bildern mehr vertrauen als Prosa.
Akkurat halten
Das gesamte Problem – und der Grund, warum die meisten Infrastruktur-Dokumentationen scheitern.
Dokumentieren Sie weniger. Genauigkeit skaliert umgekehrt zur Menge. Fünfzehn genaue Seiten schlagen zweihundert veraltete.
Dokumentations-Updates an den Änderungsprozess koppeln. Eine Änderung, die Infrastruktur verändert, ist erst dann vollständig, wenn die Dokumentation das widerspiegelt. Das ist der einzige Mechanismus, der zuverlässig funktioniert.
Automatisieren Sie, was sich ermitteln lässt. Inventar, Adressen, Konfigurationen und Topologie können oft generiert werden. Generierte Dokumentation kann nicht in dem Maß veralten wie handgeschriebene.
Handschriftlich nur das, was sich nicht ermitteln lässt. Zweck, Ownership, Kritikalität, Abhängigkeiten, bekannte Ausfallmodi, was nicht zu tun ist. Maschinen können keines davon ableiten.
Alles datieren, und das Datum prominent anzeigen. Ein sichtbares „zuletzt verifiziert“-Datum hilft Lesern, ihr Vertrauen zu kalibrieren.
Nach Tier gestaffelt prüfen, vierteljährlich für Tier 1.
Im Vorfall beheben. Der Moment, in dem jemand entdeckt, dass die Dokumentation falsch ist, ist der Moment, in dem er das Wissen hat, um sie zu korrigieren. Machen Sie daraus eine Aufgabe von fünf Minuten – kein Ticket.
Automatisierung und Ermittlung
Es lohnt sich, hier zu investieren, weil es den größten Ausfallmodus entfernt.
Configuration Management-Datenbanken, Inventare der Cloud-Provider, Infrastructure-as-Code-Repositories und Network-Discovery-Tools können alle kontinuierlich genaue Informationen über den aktuellen Zustand generieren. Alles, was sie erzeugen können, sollte nicht manuell gepflegt werden.
Die Aufteilung, die funktioniert: Maschinen dokumentieren, was existiert, Menschen dokumentieren, was es bedeutet. Ein automatisch generiertes Inventar sagt Ihnen, dass ein Server existiert und was darauf installiert ist. Nur eine Person kann Ihnen sagen, dass es genau dieser ist, der zwischen 2 Uhr und 4 Uhr nicht neu gestartet werden darf – wegen des Batch Runs.
Wo Infrastruktur als Code definiert ist, ist der Code die Dokumentation dessen, was existiert. Was noch geschrieben werden muss, sind die Absicht, das operative Wissen und die Ausfallmodi.
Wer ist dafür verantwortlich
Weisen Sie die Ownership pro System zu, statt Dokumentation zur Aufgabe einer einzelnen Person zu machen – denn die überlebt den Weggang dieser Person nie.
Das Team, das ein System betreibt, besitzt dessen Dokumentation. Eine namentlich benannte Person besitzt den übergreifenden Standard, die Vorlagen und die Review-Frequenz. Und der Änderungsprozess erzwingt Updates, denn Ownership ohne Mechanismus ist nur eine Absicht.
Das typische Fehlerbild ist ein Dokumentations-Owner, der allen anderen hinterherläuft. Das funktioniert etwa zwei Monate.
Die Dokumentation testen
Das Äquivalent zu einem Restore-Test – und genauso vernachlässigt.
Nehmen Sie jemanden, der das System nicht gebaut hat, geben Sie ihm nur die Dokumentation und bitten Sie ihn, eine routinemäßige operative Aufgabe zu erledigen. Ein kontrollierter Neustart, ein Failover, ein Restore in eine Testumgebung.
Alles, was er nicht aus der Dokumentation tun kann, ist eine Lücke. Alles, was er falsch macht, ist ein Defekt. Das ist unangenehm – und es ist der einzige verlässliche Weg zu wissen, ob die Dokumentation um 3 Uhr morgens funktionieren würde, denn die Person, die sie geschrieben hat, kann die Lücken immer aus dem Gedächtnis füllen.
Tun Sie das mindestens jährlich für Tier-1-Systeme, idealerweise im Rahmen eines Game Days oder eines DR-Übungsdurchlaufs.
Best Practices
Wenden Sie den 3-Uhr-Test auf alles an, bevor Sie es schreiben.
Dokumentieren Sie Tier 1 richtig und Tier 3 minimal.
Abhängigkeiten in beide Richtungen, mit Startreihenfolge.
Niemals Zugangsdaten, immer Zugriffsmethoden.
„Zuletzt verifiziert“-Datum auf jedem Datensatz.
Automatisieren Sie alles, was sich ermitteln lässt, und schreiben Sie nur Absicht und operatives Wissen von Hand.
Dokumentations-Updates werden durch den Änderungsprozess erzwungen.
Runbooks enthalten, was nicht zu tun ist.
Restore-Tests im DR-Plan datieren.
Testen Sie die Dokumentation mit jemandem, der nicht vertraut ist, jährlich.
Häufige Fehler
Zugangsdaten im Wiki.
Alles mit derselben Tiefe dokumentieren, sodass nichts gepflegt wird.
Abhängigkeiten nur in eine Richtung dokumentieren.
Keine Startreihenfolge, sodass die Wiederherstellung länger dauert als der Ausfall.
Konfigurations-Dumps, die bei Ankunft schon veraltet sind.
Diagramme ohne Datum und ohne Owner, denen man lange vertraut, obwohl sie nicht mehr wahr sind.
Dokumentation als Projekt-Liefergegenstand, danach nie wieder aktualisiert.
Eine Person ist nominell für alles verantwortlich.
DR-Pläne, die auf der Infrastruktur gespeichert sind, die sie abdecken.
Backups dokumentiert, Restores nie getestet.
Kein „zuletzt verifiziert“-Datum, sodass Leser nicht beurteilen können, was sie glauben sollen.
Geschrieben von der Person, die es gebaut hat, getestet von niemandem.
Halten Sie fest, was nur die Person weiß, die es gebaut hat
Öffnen Sie die Vorlagen in Trupeer AI, wenden Sie Ihr Brand Kit an, damit die Dokumentation Ihren Standards entspricht, und bearbeiten Sie jeden Abschnitt direkt. Das Setup finden Sie im Vorlagen-Guide.
Automatisierung deckt ab, was existiert. Was sie nicht erfassen kann, ist das operative Wissen: die Reihenfolge, in der Dinge zurückkommen, die Prüfung, die Sie vor dem Failover durchführen, und der Grund, warum niemand diesen Service dienstags neu startet.
Dieses Wissen lebt bei ein oder zwei Personen und geht verloren, wenn sie gehen. Lassen Sie sie einen Failover oder Restore durchgehen, während Sie aufnehmen, und Trupeer AI erstellt das geschriebene Runbook sowie einen gesprochenen Video-Durchlauf aus demselben Durchlauf – in der Reihenfolge, in der sie es tatsächlich tun, statt in der Reihenfolge, an die sie sich beim Schreiben erinnern würden.
Außerdem nimmt es ihnen weniger Zeit als das Schreiben – was wichtig ist, weil der Grund, warum operatives Wissen undokumentiert bleibt, darin liegt, dass die Personen, die es haben, am beschäftigtsten sind. Übersetzen Sie es in 65+ Sprachen für verteilte Teams und halten Sie den Satz in Ihrer Knowledge Base neben den Runbooks bereit.
Aufnehmen. Branden. Übersetzen. Trupeer-n.
Häufig gestellte Fragen
Gibt es eine kostenlose Vorlage für Infrastruktur-Dokumentation in Word?
Ja. Word enthält die Runbooks, den Architektur-Überblick und den DR-Plan – die Teile, die wirklich erzählerisch sind. Kostenlos herunterladen, kein Sign-up, kein Wasserzeichen.
Gibt es eine kostenlose Vorlage für Infrastruktur-Dokumentation in Excel?
Ja, und Excel erledigt den Großteil der Arbeit. Es enthält das System-Inventar mit Kritikalitäts-Tiers und „zuletzt verifiziert“-Daten, die Dependency-Matrix in beide Richtungen, Netzwerkinformationen, Tracking für Zertifikatsabläufe und den Review-Zeitplan.
Gibt es eine kostenlose Vorlage für Infrastruktur-Dokumentation in PDF?
Ja, als genehmigte Versionen und für alles, was ein Auditor oder ein Kunde sehen möchte. Halten Sie die Arbeitskopien editierbar, denn Infrastruktur-Dokumentation, die nicht schnell aktualisiert werden kann, wird nicht aktualisiert.
Kann ich eine kostenlose Vorlage für Infrastruktur-Dokumentation herunterladen?
Ja, jedes Format ist ein kostenloser Download ohne Konto und ohne Attribution.
Gibt es kostenlose Vorlagen für IT-Dokumentation?
Ja. Diese Seite behandelt speziell Infrastruktur. Für IT-Dokumentation breiter gefasst, einschließlich Prozesse, Richtlinien und How-to-Material, siehe IT-Dokumentationsbeispiele und Vorlagen, und für IT-Verfahren die IT-SOP-Vorlage.
Gibt es eine IT-Dokumentationsvorlage in Word?
Ja, auf der Seite IT-Dokumentationsbeispiele und Vorlagen. Diese Seite ist enger gefasst und deckt die Systeme, Netzwerke und Abhängigkeiten ab, aus denen Ihre Infrastruktur besteht.
Gibt es eine Vorlage für Projekt-Dokumentation in Word, kostenlos zum Download?
Ja, auf der Seite Vorlage für Projekt-Dokumentation. Projekt-Dokumentation deckt den Umfang, den Plan und die Deliverables eines Projekts ab, während Infrastruktur-Dokumentation beschreibt, was in der Produktion existiert – unabhängig davon, welches Projekt es gebaut hat.
Was ist IT-Infrastruktur-Dokumentation?
Eine Aufzeichnung der Systeme, Netzwerke, Services und Abhängigkeiten, die Ihre Umgebung ausmachen – zusammen mit dem operativen Wissen, das benötigt wird, um sie zu betreiben und wiederherzustellen. Sie deckt ab, was existiert, worauf was angewiesen ist, wie „normal“ aussieht und wie man reagiert, wenn etwas kaputtgeht.
Was sollte Infrastruktur-Dokumentation enthalten?
Ein System-Inventar mit Ownern und Kritikalität, Abhängigkeiten in beide Richtungen mit Startreihenfolge, Netzwerk- und Konnektivitätsdetails, Runbooks für kritische Systeme, Zugriffsmethoden aber niemals Zugangsdaten, Backup- und Disaster-Recovery-Details einschließlich des letzten erfolgreichen Restore-Tests sowie ein „zuletzt verifiziert“-Datum für alles.
Wie halten Sie Infrastruktur-Dokumentation aktuell?
Dokumentieren Sie weniger, automatisieren Sie alles, was sich ermitteln lässt, und koppeln Sie Dokumentations-Updates an Ihren Änderungsprozess, sodass eine Änderung erst dann vollständig ist, wenn die Dokumentation sie widerspiegelt. Setzen Sie auf jeden Datensatz ein sichtbares „zuletzt verifiziert“-Datum, prüfen Sie nach Kritikalitäts-Tier und lassen Sie Fehler von jeder Person sofort beheben, statt ein Ticket zu eröffnen.
Sollten Zugangsdaten in der Dokumentation gespeichert werden?
Nein. Keine Passwörter, API-Keys, Verbindungsstrings oder privaten Keys – in keinem System, weder vorübergehend noch anderweitig. Dokumentieren Sie stattdessen, welches Vault oder welcher Secrets Manager die Zugangsdaten hält, wer Zugriff gewähren kann und das Break-Glass-Verfahren für Notfälle. Das ist das, was jemand während eines Vorfalls tatsächlich braucht – und es ist sicher, es aufzuschreiben.
Wie viel Infrastruktur sollten Sie dokumentieren?
Genug, um den 3-Uhr-Test für kritische Systeme zu bestehen – und sehr wenig für den Rest. Tier-1-Systeme brauchen vollständige Runbooks, Dependency-Maps und getesteten DR. Tier-3-Systeme brauchen eine Inventarzeile und einen Owner. Alles mit derselben Tiefe zu dokumentieren ist der Grund, warum die meisten Infrastruktur-Dokumentationen am Ende veraltet sind.
Was ist ein Runbook?
Ein operatives Dokument für ein einzelnes System, das abdeckt, wie „normal“ aussieht, was häufige Alerts bedeuten, wie man es sicher neu startet – einschließlich Reihenfolge und Voraussetzungen –, bekannte Ausfallmodi, was nicht zu tun ist und wann zu eskalieren ist. Es ist das, was jemand während eines Vorfalls öffnet, und es sollte für eine kompetente Person geschrieben sein, die mit diesem spezifischen System nicht vertraut ist.
Wie dokumentieren Sie Abhängigkeiten?
In beide Richtungen, denn während eines Vorfalls müssen Sie wissen, was dieses System benötigt – und was ausfällt, wenn es stoppt. Fügen Sie die Startreihenfolge hinzu, ob jede Abhängigkeit hart oder weich ist, und externe Abhängigkeiten wie Identitätsanbieter, DNS und Zahlungsprozessoren, die Ausfälle verursachen, die Sie nicht selbst beheben können.
Wie oft sollte Infrastruktur-Dokumentation überprüft werden?
Nach Kritikalitäts-Tier: vierteljährlich für Tier 1, zweimal jährlich für Tier 2 und bei Änderungen für Tier 3. Zusätzlich zu geplanten Reviews sollte der Änderungsprozess Updates erzwingen, und jede Person, die während eines Vorfalls einen Fehler entdeckt, sollte ihn sofort beheben können.
Woher wissen Sie, ob Ihre Dokumentation wirklich funktioniert?
Testen Sie sie. Geben Sie jemandem, der das System nicht gebaut hat, nur die Dokumentation und bitten Sie ihn, eine routinemäßige operative Aufgabe durchzuführen – etwa einen kontrollierten Neustart oder einen Restore in eine Testumgebung. Alles, was sie nicht können, ist eine Lücke. Das jährlich für Tier-1-Systeme durchzuführen ist das Äquivalent zu einem Restore-Test – und wird genauso oft übersprungen.
Kann ich diese Vorlage für Infrastruktur-Dokumentation anpassen?
Ja, jede Version ist vollständig editierbar. Passen Sie die Kritikalitäts-Tiers und Felder an Ihre Umgebung an. Die beiden, die sich lohnen, beizubehalten, sind das „zuletzt verifiziert“-Datum und die Abbildung der Abhängigkeiten in beide Richtungen, denn diese bestimmen, ob die Dokumentation vertraut wird und ob sie während eines Vorfalls hilft.